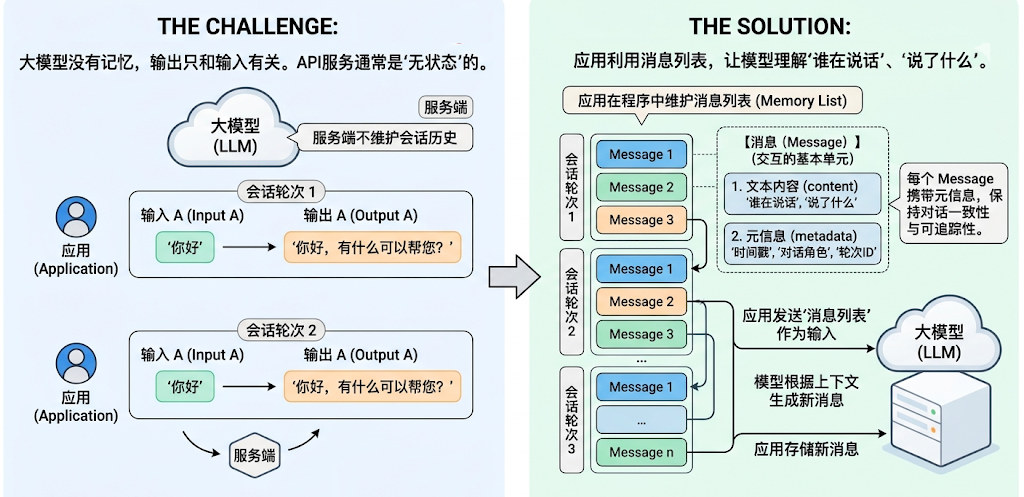
大模型本身没有记忆:它的输出只取决于这次送进模型的上下文,很多 API 服务端也不保存会话历史。因此,多轮对话的「记忆」要由应用自己维护——维护一个 Message 列表,每轮把完整历史发过去。LangChain 1.0 提供了跨模型统一的 Message 标准,OpenAI、Anthropic、Gemini 和本地模型都可以用同一套结构描述消息。
15.1 消息的内部结构
一条 Message 通常包含三个字段:
- Role:消息所属的角色或类型,例如 system、user、assistant、tool;
- Content:消息内容,可以是纯文本,也可以是多模态内容块;
- Metadata:可选元数据,例如消息 ID、响应时间、Token 消耗量、消息标签等。
Message 既代表模型接收到的输入,也代表模型生成的输出。每一轮对话由一条或多条 Message 构成,元信息让模型知道「谁在说话」「说了什么」「属于哪一轮」。
15.2 四种常用消息类型
- 系统消息(SystemMessage):系统提示词,在对话开始时设定模型角色、行为准则和上下文背景,像一份工作说明书。
- 用户消息(HumanMessage):用户的一次输入,可以是简单文本,也可以是图片、音频、文档等多模态内容。
- 助手消息(AIMessage):模型的回复,包含生成的文本、工具调用、元数据等。
- 工具消息(ToolMessage):工具调用结果,返回给模型后让模型基于结果继续生成回复。
使用不同消息类型的好处是:角色清晰、能通过 SystemMessage 精确控制行为、方便构建完整的多轮上下文、调试时也更容易追踪对话流程。
{"role": "system", "content": "你是个精通编程的软件架构师"}
{"role": "user", "content": "你好啊~"}
{"role": "assistant", "content": "我也很高兴认识你"}
{"role": "assistant", "content": "", "tool_calls": [{"name": "get_weather", "args": {"location": "北京"}, "id": "call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"}]}
{"role": "tool", "content": "今天天气很好", "tool_call_id": "call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"}
15.3 两种消息格式
LangChain 同时支持 JSON 字典格式和对象格式,二者可以互相转换:
| 角色 | 字典格式 | 对象格式 | 用途 | 示例 |
|---|---|---|---|---|
| System | {“role”: “system”, …} | SystemMessage(…) | 设定 AI 的行为、角色、规则 | 「你是一个专业的数学老师」 |
| User | {“role”: “user”, …} | HumanMessage(…) | 用户输入 | 「什么是微积分?」 |
| Assistant | {“role”: “assistant”, …} | AIMessage(…) | AI 的回复 | 「微积分是研究变化率的数学分支……」 |
| Tool | {“role”: “tool”, …} | ToolMessage(…) | 工具执行的结果 | 「今天北京天气晴朗,万里无云」 |
from langchain_core.messages import (
    HumanMessage,    # 用户消息
    AIMessage,       # AI 消息
    SystemMessage,   # 系统消息
    ToolMessage,     # 工具返回消息
)

messages = [
    SystemMessage(content="你是一个助手"),
    HumanMessage(content="你好"),
    AIMessage(content="你好!有什么可以帮你?"),
    HumanMessage(content="天气怎么样?"),
    AIMessage(content="让我查询一下..."),
    ToolMessage(content="北京:晴天", tool_call_id="call_123"),
    AIMessage(content="北京今天是晴天"),
]
字典格式更适合序列化和网络传输,对象格式在大型项目里能获得类型检查和 IDE 补全。
15.4 各消息对象的字段
15.4.1 SystemMessage
常用字段只有 content,字段名可以省略:
SystemMessage("你是个善解人意的助手")
# 等价于
SystemMessage(content="你是个善解人意的助手")
15.4.2 HumanMessage
content 是消息内容;metadata 可以带很多自定义字段,常用的有 name 和 id。当消息类型相同、需要区分不同发言者时,name 很有用。
HumanMessage(
    content="Hello!",
    name="alice",  # 可选,用户名
    id="msg_123",  # 可选,消息 ID
)
但 name 是否生效取决于模型供应商。OpenAI 的 Chat Completions 文档明确支持 name;DeepSeek 文档也写了支持,但实测模型无法识别;用 ChatOpenRouter 调用时,name 也没有正确传给模型服务。下面是一次多人发言提取的例子:
from langchain_core.messages import SystemMessage, HumanMessage
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

load_dotenv(override=True)
model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)

messages = [
    SystemMessage("你会收到多条来自不同发言者的 user 消息。严格根据 name 提取发言者和观点,输出 JSON;没有 name 就写 unknown。禁止使用『第一个人』这种相对称呼。"),
    HumanMessage(content="我认为 1+1=2", name="Bob"),
    HumanMessage(content="我认为 1+1>2", name="Tom"),
    HumanMessage(content="请列出谁说了什么,不要判断对错。", name="audience"),
]
print(model.invoke(messages).content)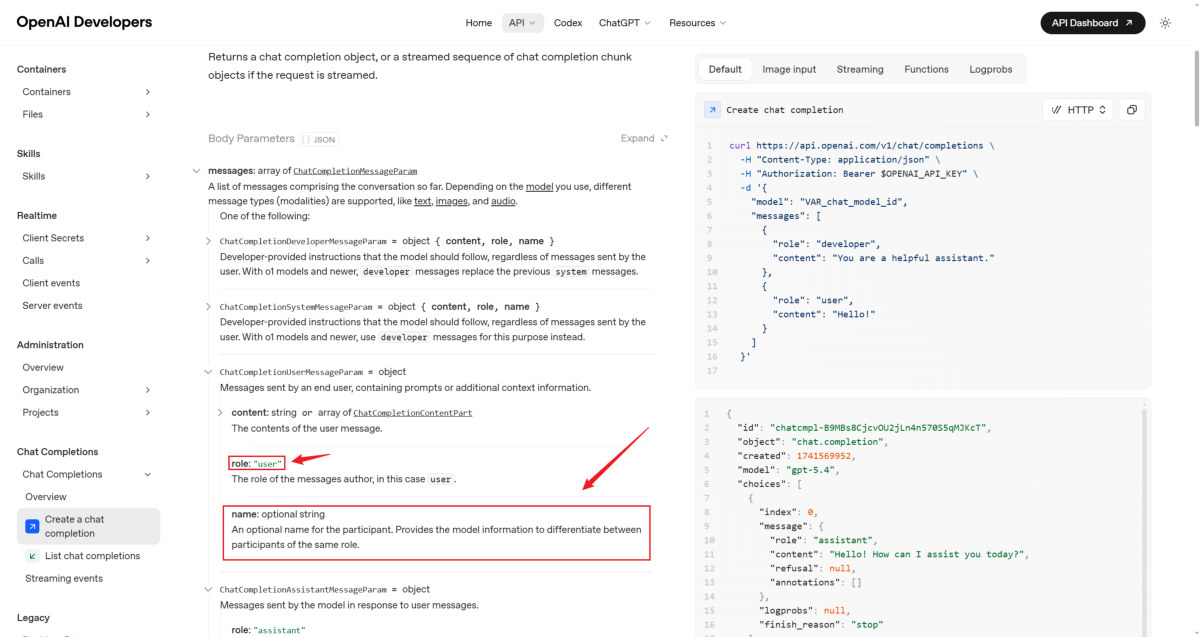
15.4.3 AIMessage
AIMessage 除了 content,还有三个常用属性:
response_metadata:模型响应中的附加元数据,例如 Token 使用量;tool_calls:模型决定调用工具时的调用列表,没有调用时为空;usage_metadata:LangChain 统一后的用量信息。
AIMessage("你好~")
# 等价于
AIMessage(content="你好~")

# 带工具调用
AIMessage(
    content="",
    tool_calls=[{
        "name": "get_weather",
        "args": {"city": "北京"},
        "id": "call_xxx",
        "type": "tool_call",
    }],
)
from rich import print as rprint
response = model.invoke("用一句话解释什么是 AI")
rprint(response.usage_metadata)
# {'input_tokens': 34, 'output_tokens': 118, 'total_tokens': 152, ...}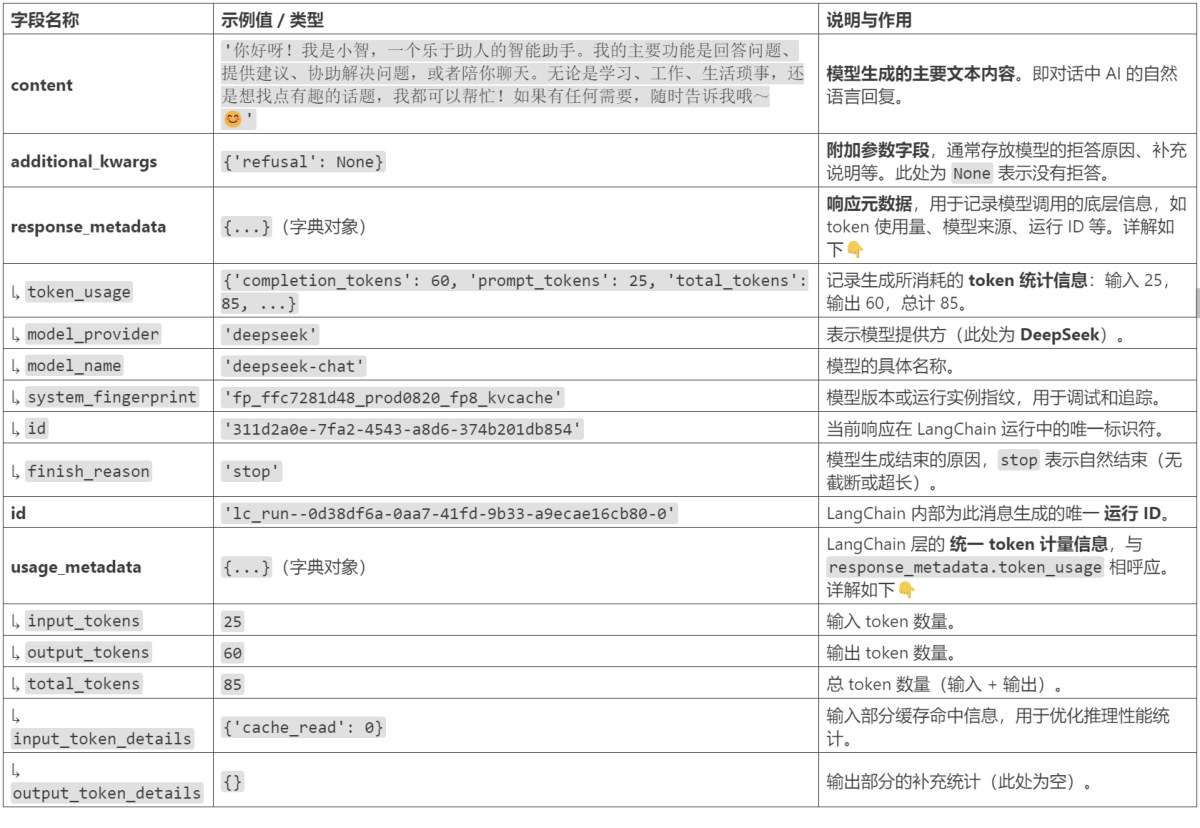
15.4.4 ToolMessage
ToolMessage 的常用字段:content(工具输出)、name(工具名称)、tool_call_id(工具调用唯一 ID)。tool_call_id 必须和前面 AIMessage 中 tool_calls 的 id 一致,并且 ToolMessage 要紧邻匹配的 AIMessage。
from langchain_core.messages import AIMessage, ToolMessage, HumanMessage

ai_message = AIMessage(
    content=[],
    tool_calls=[{
        "name": "get_weather",
        "args": {"location": "北京"},
        "id": "call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s",
    }],
)
tool_message = ToolMessage(
    content="今天北京天气晴朗,万里无云~",
    tool_call_id="call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s",
)

messages = [
    HumanMessage(content="北京天气如何"),
    ai_message,
    tool_message,
]
print(model.invoke(messages))
15.5 实战:对话历史管理
15.5.1 每轮都要传完整历史
关键规则:每次调用必须传递完整的对话历史,并且是在原有消息列表上追加,不能重新创建列表。
# 错误示例:第二次调用没有历史
response1 = model.invoke("我叫张三")
response2 = model.invoke("我叫什么?")  # AI 不记得

# 错误示例:重新创建列表
conversation = [{"role": "user", "content": "问题1"}]
response1 = model.invoke(conversation)
conversation = [{"role": "user", "content": "问题2"}]  # 历史丢失
response2 = model.invoke(conversation)

# 正确做法:追加 AI 回复
conversation = []
conversation.append({"role": "user", "content": "我叫张三"})
response1 = model.invoke(conversation)
conversation.append({"role": "assistant", "content": response1.content})
conversation.append({"role": "user", "content": "我叫什么?"})
response2 = model.invoke(conversation)  # AI 记得
15.5.2 只保留最近 N 轮
对话历史会越来越长,Token 和成本随之上涨。可以始终保留 system 消息,只保留最近 N 轮对话:
def keep_recent_messages(messages, max_pairs=3):
    """保留 system 消息和最近 N 轮对话(每轮 = user + assistant)"""
    system_msgs = [m for m in messages if m.get("role") == "system"]
    conversation_msgs = [m for m in messages if m.get("role") != "system"]
    recent_msgs = conversation_msgs[-(max_pairs * 2):]
    return system_msgs + recent_msgs
long_conversation = [{"role": "system", "content": "你是 Python 导师"}]
long_conversation.append({"role": "user", "content": "什么是列表?用一句解释"})
r1 = model.invoke(long_conversation)
long_conversation.append({"role": "assistant", "content": r1.content})
long_conversation.append({"role": "user", "content": "列表和元组有什么区别?用一句解释"})
r2 = model.invoke(long_conversation)
long_conversation.append({"role": "assistant", "content": r2.content})
long_conversation.append({"role": "user", "content": "什么是字典呢?用一句解释"})
r3 = model.invoke(long_conversation)
long_conversation.append({"role": "assistant", "content": r3.content})
print(f"原始消息数: {len(long_conversation)}")
optimized = keep_recent_messages(long_conversation, max_pairs=2)
print(f"优化后消息数: {len(optimized)}")
optimized.append({"role": "user", "content": "我第一个问题问的是什么?"})
print(model.invoke(optimized).content)原始消息 7 条,保留 system 加最近 2 轮后变成 5 条。因为第一个问题已经被裁掉,模型回答的是「列表和元组有什么区别」,而不是最初那个问题——这就是裁剪历史的代价。
15.5.3 多轮对话聊天机器人
把模型初始化、流式响应和消息列表拼接在一起,就是一个可用的命令行聊天机器人。keep_recent_messages() 使用上面的定义。
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

load_dotenv(override=True)

MODEL_NAME = "gpt-5.4-mini"
MAX_PAIRS_HISTORY = 10
EXIT_WORD = "quit"

model = init_chat_model(
    model=MODEL_NAME,
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)

messages = [
    {
        "role": "system",
        "content": "你是小谷助手,一名耐心、友好的智能助手。用自然、清晰的方式回答用户问题。",
    }
]

print(f"请输入问题,输入 {EXIT_WORD} 结束对话\n")
i = 1
while True:
    print("\n", "=" * 10, f"-> 第 {i} 轮对话开始 <-", "=" * 10, "\n")
    user_input = input("请输入:")

    if user_input.lower() == EXIT_WORD:
        print("对话已结束,欢迎下次再来!")
        break

    messages.append({"role": "user", "content": user_input})

    print("小谷助手:", end="", flush=True)
    reply_content = ""
    memory_messages = keep_recent_messages(messages, max_pairs=MAX_PAIRS_HISTORY)

    for chunk in model.stream(memory_messages):
        if chunk.content:
            print(chunk.content, end="", flush=True)
            reply_content += chunk.content

    print("\n", "=" * 10, f"-> 第 {i} 轮对话结束 <-", "=" * 10, "\n")
    i += 1
    messages.append({"role": "assistant", "content": reply_content})
15.6 消息属性:content 与 content_blocks
15.6.1 content
消息的 content 是弱类型的,支持字符串和列表(列表元素通常是字典)。纯文本直接传字符串;多模态内容则使用字典列表,格式遵循模型供应商的 API 规范。
from langchain.messages import HumanMessage

msg1 = HumanMessage(content="你好啊")
msg2 = HumanMessage("你好啊")  # 纯文本可以省略字段名
print(msg1)
print(msg2)
以 OpenAI 为例,图文输入可以写成 text 加 image_url 的列表:
import base64
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage
from dotenv import load_dotenv
import os

load_dotenv(override=True)
model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)

def encode_image(img_path, img_type="jpeg"):
    with open(img_path, "rb") as img_file:
        return f"data:image/{img_type};base64,{base64.b64encode(img_file.read()).decode('utf-8')}"

base64_image = encode_image("image_test.png")
response = model.invoke([
    HumanMessage(content=[
        {"type": "text", "text": "这张图里有什么?"},
        {"type": "image_url", "image_url": base64_image},
    ])
])
print(response.content)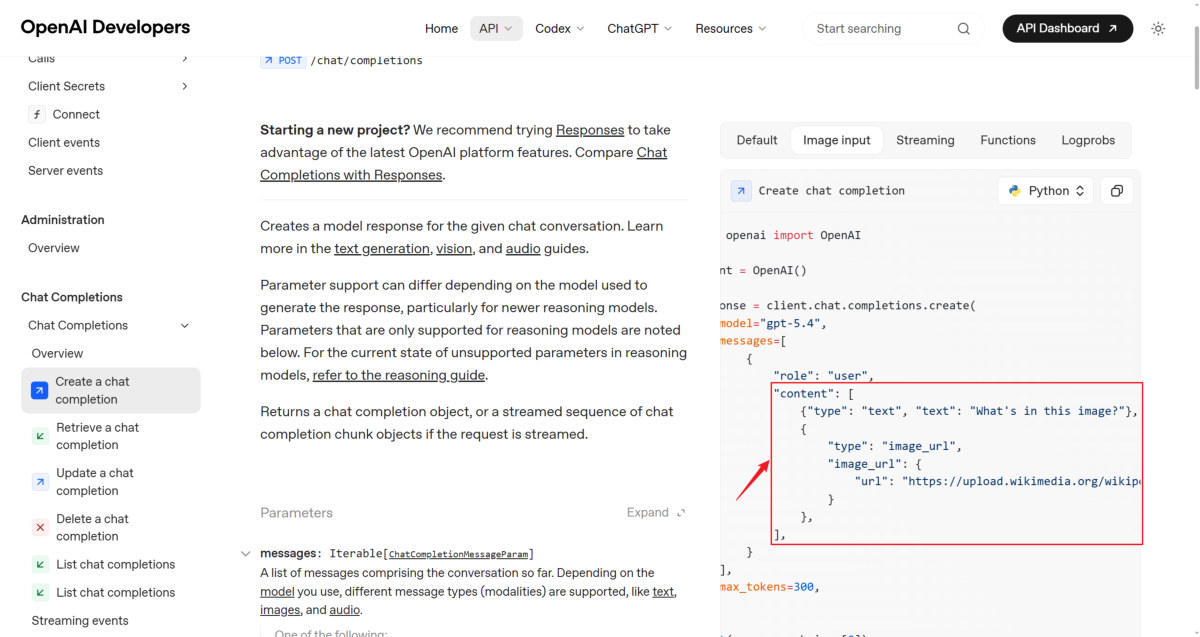
15.6.2 content_blocks
不同厂商对图片、音频、思维链的格式定义不一致,content_blocks 用一套标准结构抹平差异。它是 list[TypedDict],每个 block 都有 type 字段,支持 text、image、audio、video、tool_call、reasoning 等类型。
输入侧推荐使用 content_blocks 构建 HumanMessage 或 AIMessage,同一套代码可以在不同厂商模型之间切换:
from langchain.messages import HumanMessage

response = model.invoke([
    HumanMessage(
        content_blocks=[
            {"type": "text", "text": "这张图里有什么?"},
            {
                "type": "image",
                "base64": base64_image,
                "mime_type": "image/png",
            },
        ]
    )
])
print(response.content)
输出侧同样可以统一格式。以 DeepSeek 为例,思考内容原本放在 additional_kwargs.reasoning_content 里;用 content_blocks 可以直接拿到标准的 reasoning block:
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model="deepseek:deepseek-v4-flash",
    extra_body={"thinking": {"type": "enabled"}},
)
response = model.invoke("你好,一句话回答")

print(response.content)
print(response.content_blocks)
# [{'type': 'reasoning', 'reasoning': '...'},
#  {'type': 'text', 'text': '你好,请说出您的问题……'}]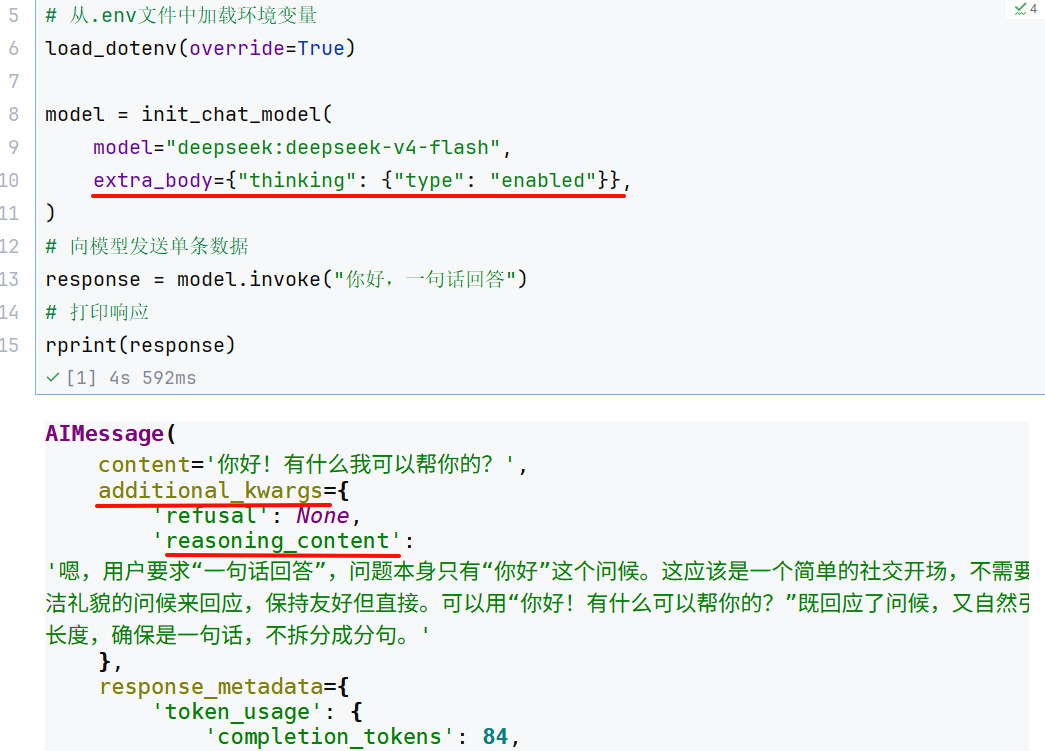
注意 content_blocks 是懒加载的,调用时才解析。需要获取思维链或引用(Citations)信息时,优先检查 response.content_blocks,而不是只看 response.content。
15.7 小结
消息是 LangChain 模型交互的基本单元:角色区分谁在说话,content 携带内容,metadata 保存上下文信息。多轮对话的关键不是「模型记得」,而是应用每轮把完整历史(或裁剪后的历史)重新发给模型。
下一篇:LangChain 1.2 入门(十六):提示词模板 ChatPromptTemplate 与高级用法;上一篇:用 LangSmith 查看追踪与监控指标。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。