环境就绪后,最后一节看应用落地的形态。大模型应用的技术特点是「门槛低、天花板高」:写第一个对话程序只要几行代码,但要做到生产可用,需要组合检索、工具、记忆、评测等一整套能力。
05.1 RAG 开发
背景。大模型有两个绕不开的问题。第一是知识冻结:随着 LLM 规模扩大,训练成本和周期增加,模型无法实时学习最新信息,遇到「请推荐现在的热门影片」这类时间敏感的问题就答不准。第二是幻觉:问题涉及训练中从未学过的信息时,模型无法给出准确答复,转而编造答案。
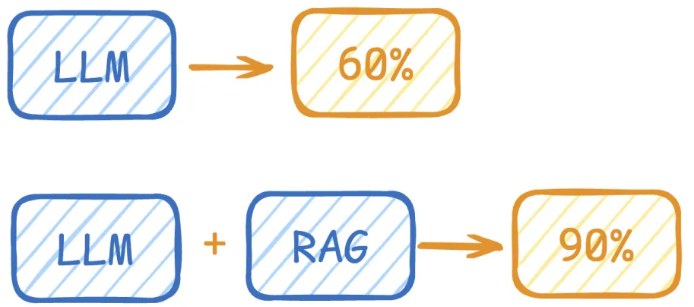
一个直观的例子。让 LLM 参加考试,面对陌生领域时答复能力有限,容易「放飞自我」;如果此时通过 RAG 提供一些提示和思路,让模型顺着这些线索作答,正确率可以从 60% 提升到 90%。
RAG 是什么?Retrieval-Augmented Generation,检索增强生成。它先检索外部资料,再把资料作为上下文交给模型生成答案。完整链路可以拆成入库和查询两段:
- 本地文件进入系统,可以是结构化数据(二维表),也可以是非结构化文本(PDF、Word、TXT 等);
- 非结构化数据加载器(Unstructured Loader)把文件读成纯文本;
- 文本切分器(Text Splitter)把长文本切成 Text Chunk;
- 嵌入模型(Embedding Model)把每个 chunk 转成向量;
- 向量写入向量数据库(Vector Database),完成存储与索引;
- 用户提问(User Query)同样经过嵌入模型转成查询向量;
- 在向量数据库里做相似度搜索(Similarity Search),召回相近的 chunk;
- 把召回内容作为上下文,和用户问题一起填进提示词模板;
- 提示词交给 LLM,生成最终答案并返回给用户。
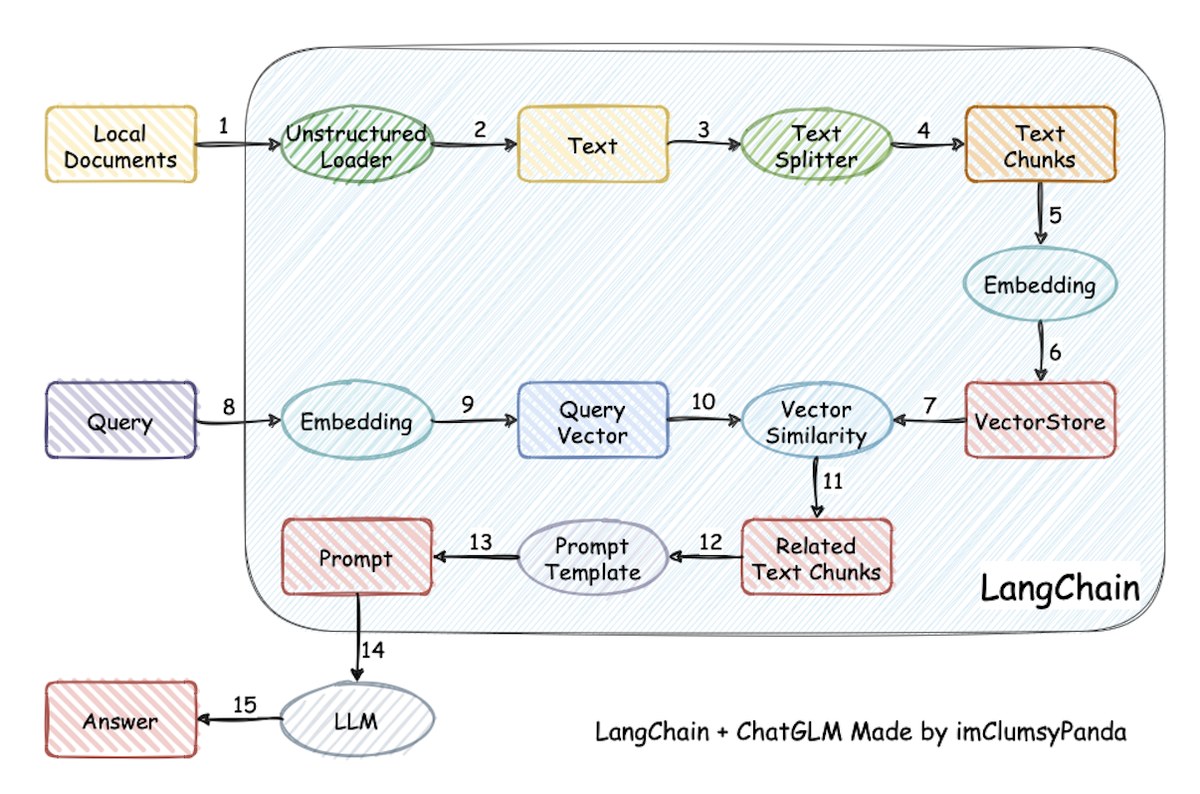
如果把流程画成带编号的图,检索对应相似度搜索那一步,增强对应「提示词里带上检索结果」那一步,生成对应 LLM 输出答案那一步。三条链路合起来,就是「检索—增强—生成」。
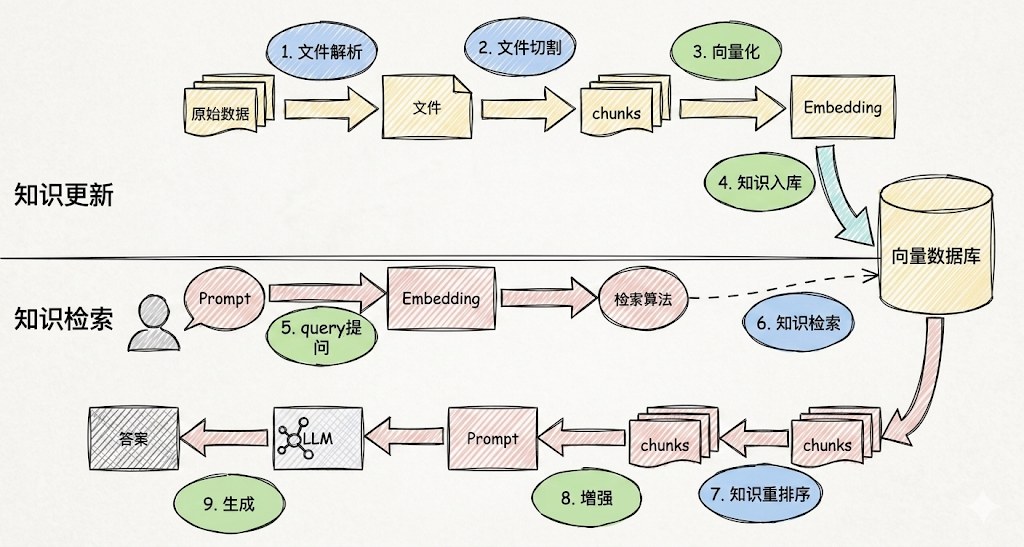
工程上的难点集中在四处:
- 文件解析:PDF 内部可能包含图片、表格,图片上还有文字,需要专门处理;
- 文件切割:没有固定格式,切多大、按什么边界切,直接决定召回质量;
- 知识检索:文档数量增加后,召回准确率会下降;
- 知识重排序:先召回较多 chunk(例如 top 20 或 top 50),再用 reranker(重排器)精排,提高准确率,避免 LLM 处理无关信息,减少时间和成本。
Reranker 的取舍要算清楚:它比只做基础向量检索的 RAG 成本更高,但比完全依赖 LLM 生成答案成本低。适合追求高精度、高相关性的场景,例如专业知识库、客服系统;如果服务对响应时间要求很高,引入 reranker 会增加召回时间和检索延迟,就要谨慎。
05.2 Agent 开发
Agent 的思路是充分利用 LLM 的推理决策能力,再加上规划、记忆和工具调用,构造一个能够独立思考、逐步完成目标的智能体。
OpenAI 的翁丽莲(Lilian Weng)在 2023 年 6 月的个人博客中提出了现代 AI Agent 架构,可以用一个公式概括:
Agent = LLM + Planning + Tools + Memory + Action
博客地址:https://lilianweng.github.io/posts/2023-06-23-agent/
用「打车去西藏玩」类比:大脑中枢是规划行程的你;Planning 负责拆步骤,比如先规划路线,再订饭店和酒店;Tools 负责调用 MCP 或 Function Calling 等接口,完成打车、订酒店;Memory 保证沟通时不丢上下文,比如订的是西藏路上的酒店,而不是聊着聊着忘了最初的目的;Action 负责真正执行,不能只停留在纸上谈兵。
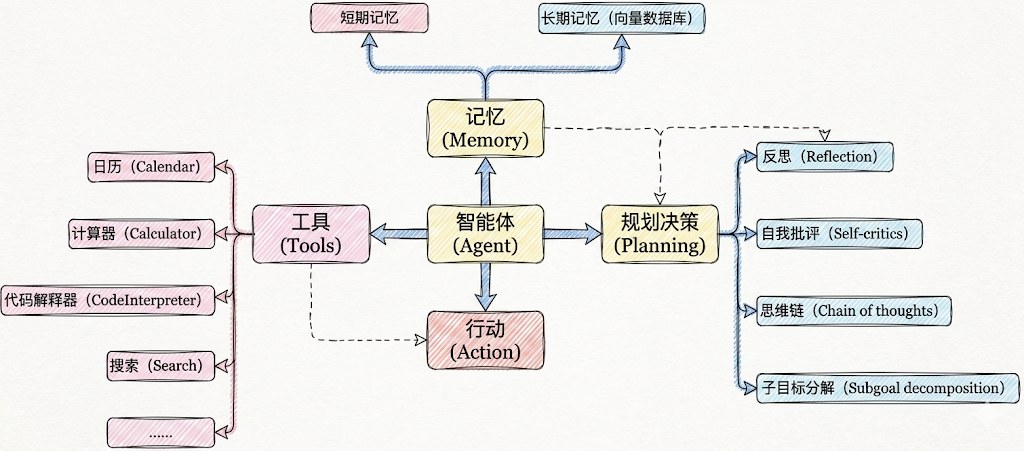
五个核心要素可以逐个拆开看:
- 大模型(LLM)作为大脑:提供推理、规划和知识理解能力,是决策中枢。它还要能把推理和规划过程呈现出来,才能应对未知任务。
- 规划决策(Planning):通过任务分解、反思与自省处理复杂任务。常见手段包括思维链(Chain of Thought)、子目标拆解、自我批评(Self-critics)和反思(Reflection),再根据反馈调整策略。
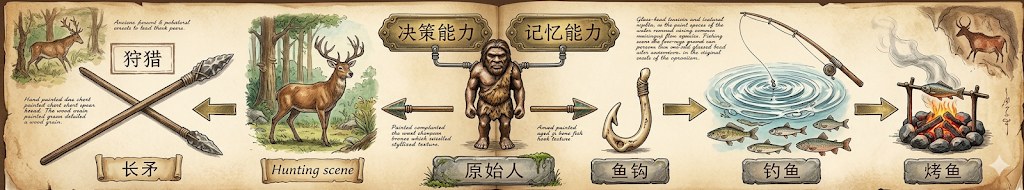
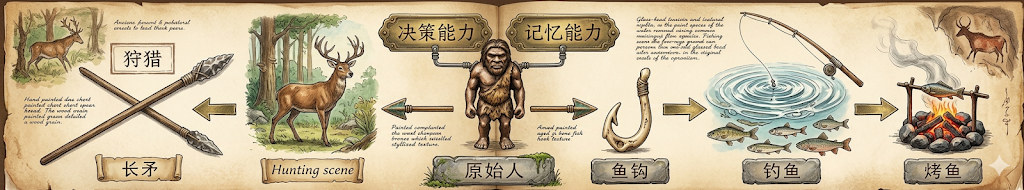
- 工具使用(Tool Use):调用 API、数据库、搜索引擎、计算器、代码解释器等外部工具,扩展能力边界。工具不是新概念,人类一直在用长矛、鱼钩这类工具放大自身能力;Agent 只是把工具换成了软件接口。
- 记忆(Memory):短期记忆保存单次对话的上下文,属于临时存储,受模型上下文窗口限制。早期 ChatGPT 大约支持 8k token,GPT-4 大约 32k token;目前的新一代旗舰模型已经把窗口推到百万级,例如 100 万、200 万 token,个别方案宣称支持 1000 万 token,相当于约 2000 万字文本或 20 小时视频。长期记忆则横跨多个会话,用来保存用户偏好、历史指令等核心知识,可以通过模型参数微调、知识图谱或向量数据库实现。
- 行动(Action):实际执行决策,既包括软件接口操作(自动订票),也包括物理交互(机器人搬运),还包括检索、推理、编程等动作。
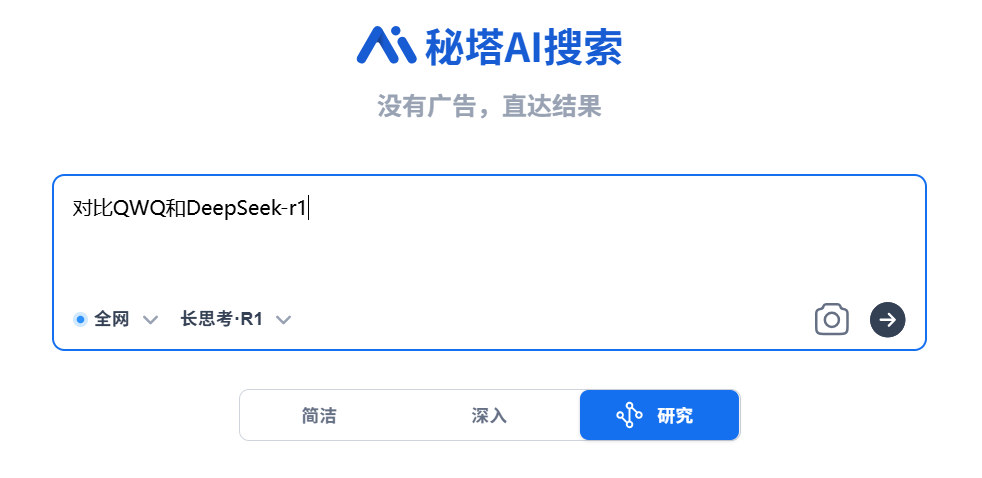
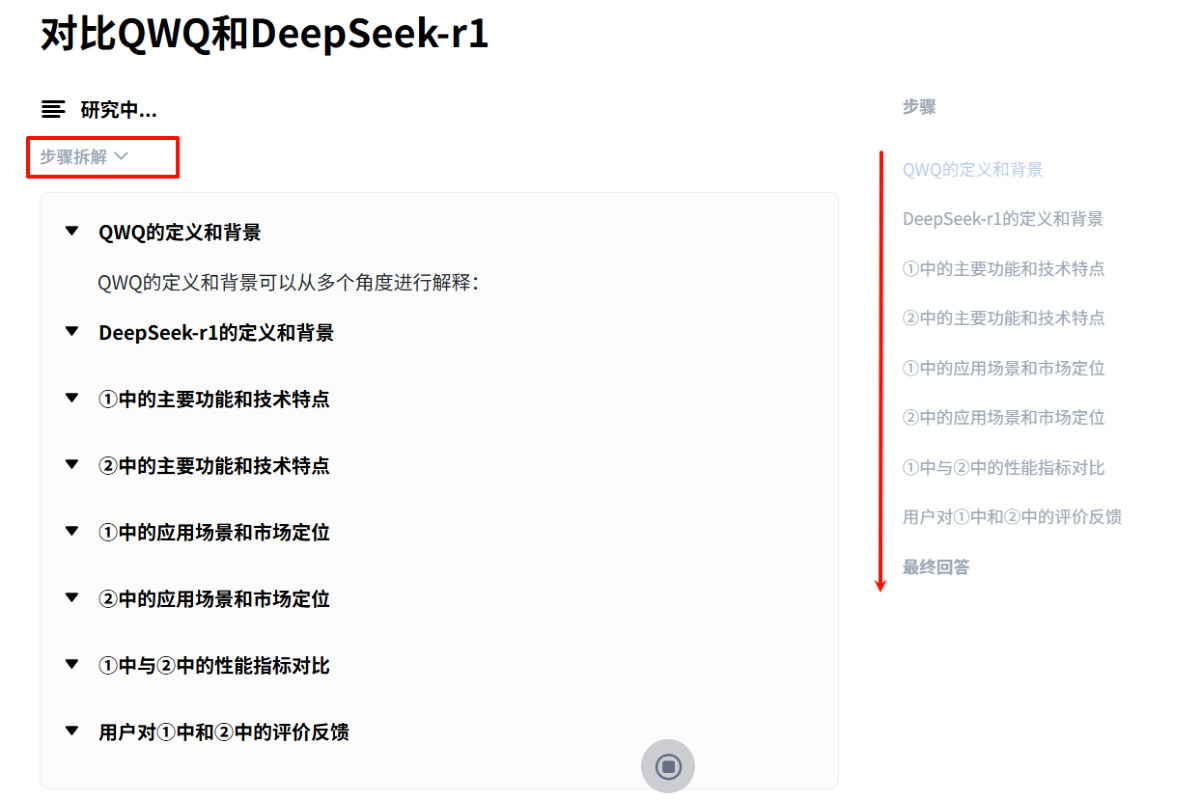
把工具使用单独拿出来看,一个带工具的搜索产品会先拆解问题,再按步骤检索、汇总,最后生成答案。下面两张图展示的就是这个过程:先在输入框里提出对比类问题,系统把任务拆成「定义和背景、功能特点、应用场景、性能对比、用户评价」等步骤,再逐步检索。
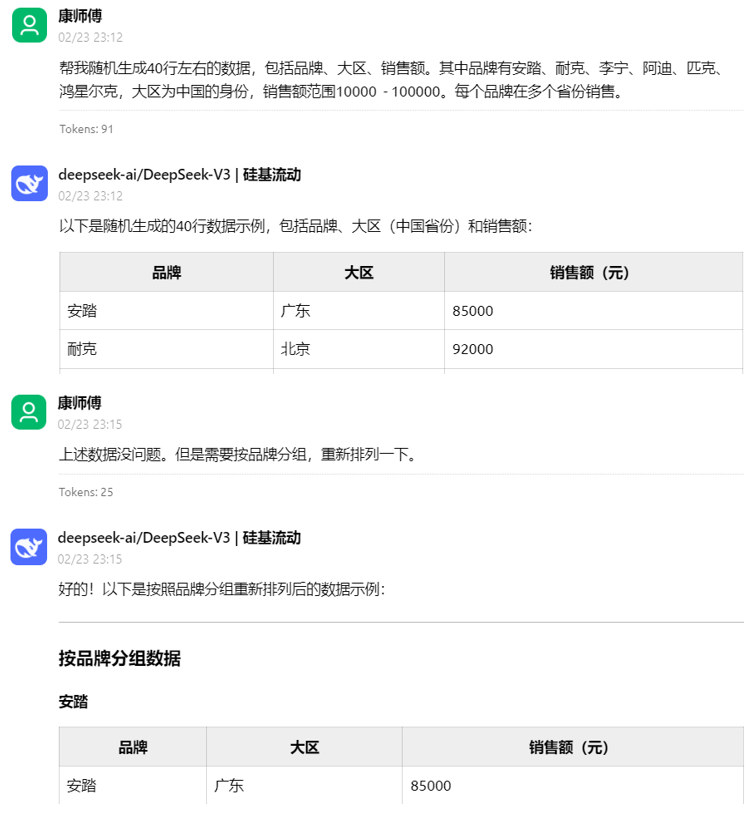
记忆在对话产品里最直观。下图是一次多轮对话:用户先要求生成一批包含品牌、大区、销售额的数据,随后只说「按品牌分组,重新排列一下」,模型仍能接着上文完成调整。如果没有上下文记忆,第二轮就无从下手。
把这些模块串起来,智能体会形成一条完整流程:读取以往的经验和记忆 → 规划子目标 → 调用相应工具处理 → 输出结果给用户 → 反思并调整。
05.3 大模型应用开发的四个场景
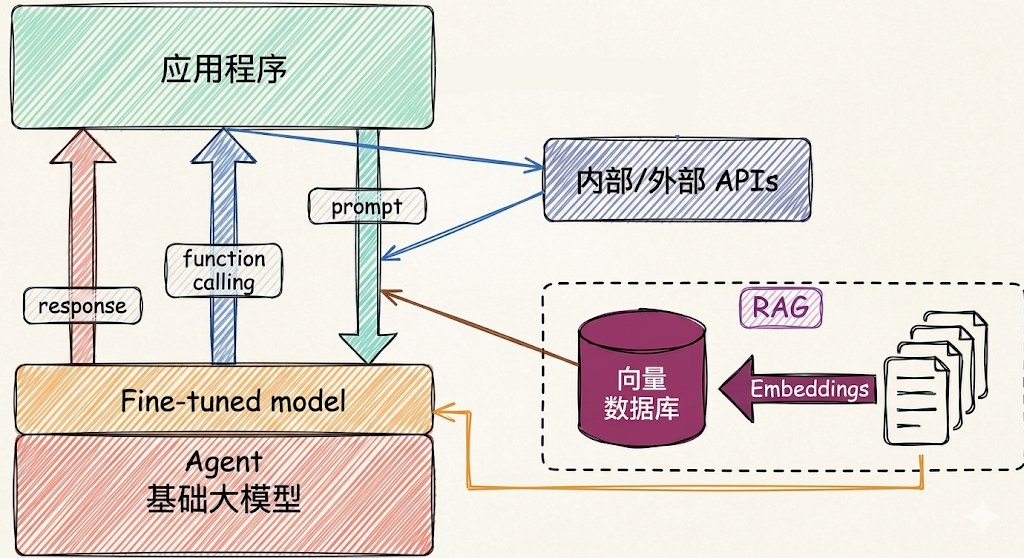
场景 1:纯 Prompt。Prompt 是操作大模型的唯一接口。用人的视角看:你说一句,它回一句;你再说一句,它再回一句。
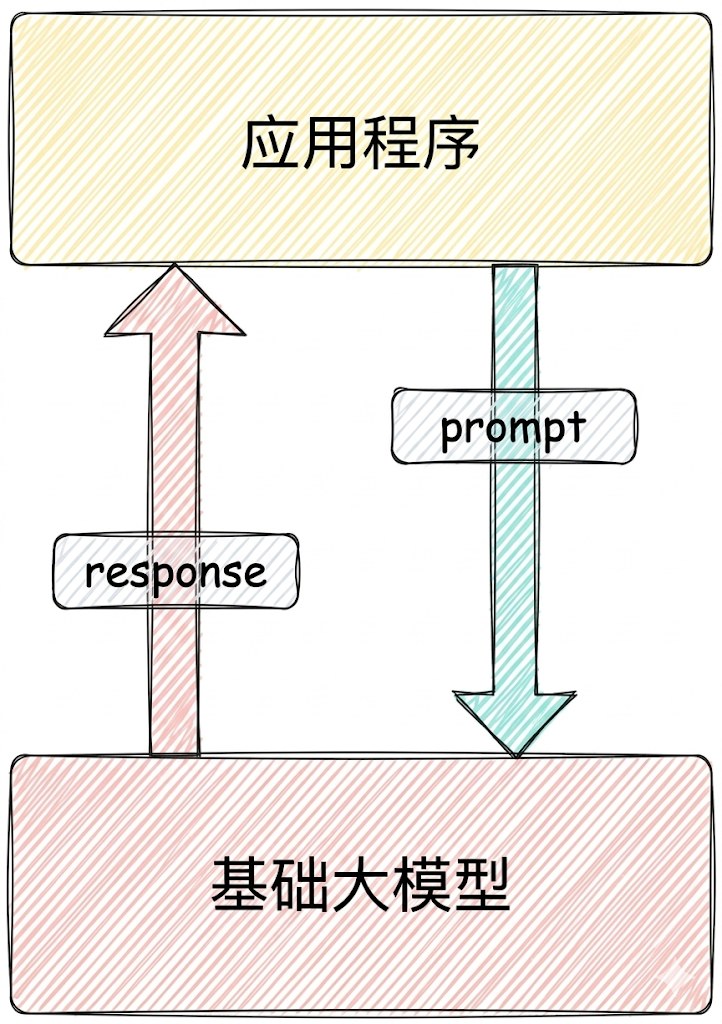
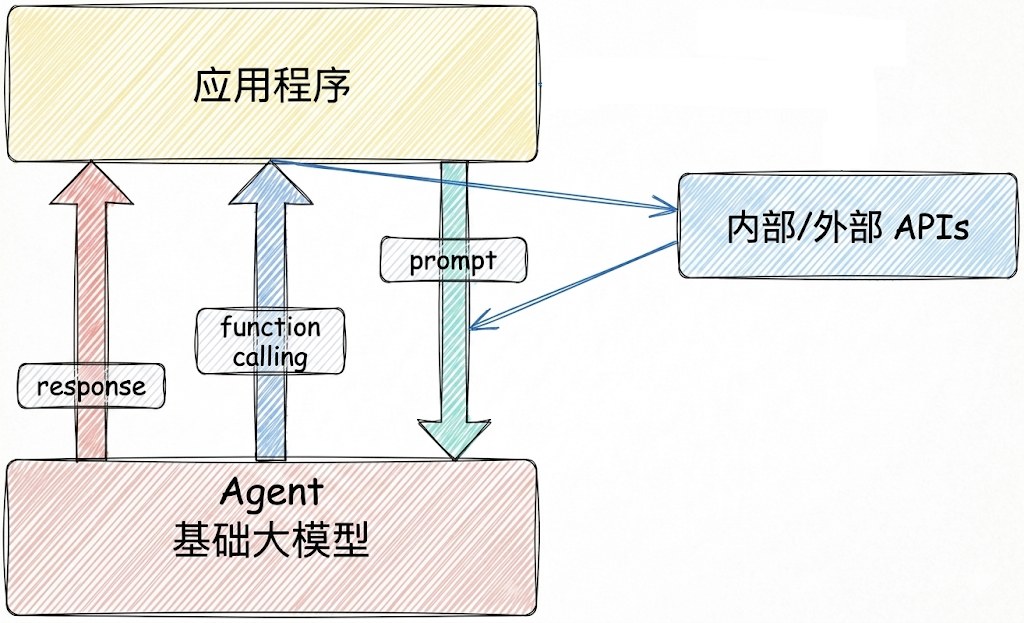
场景 2:Agent + Function Calling。Agent 会主动提要求;需要对接外部系统时,它要求执行某个函数。用人的视角看:你问「我明天去杭州出差,要带伞吗?」,它让你先看天气预报,你把结果告诉它,它再回答要不要带伞。
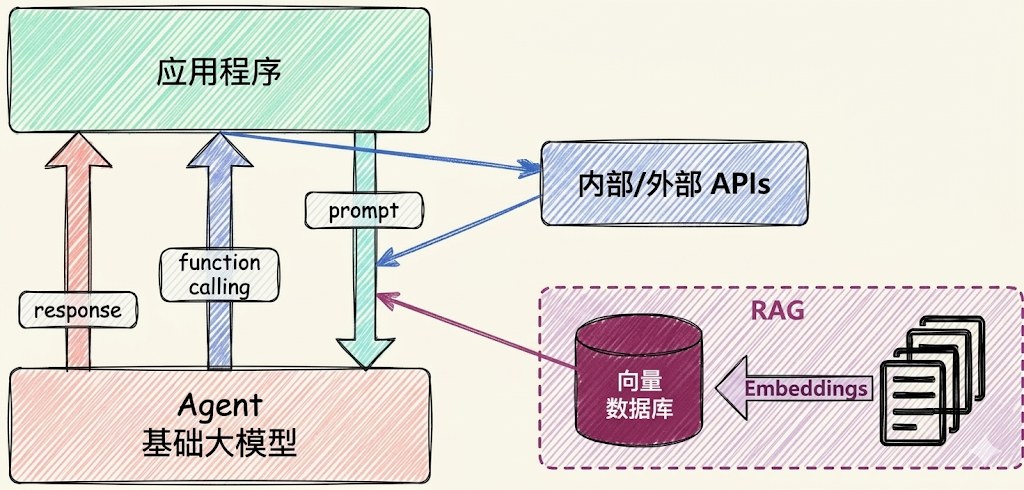
场景 3:RAG。需要补充领域知识时使用。Embeddings 把文字转成便于相似度计算的编码,也就是向量;向量数据库负责存储和查找;向量搜索根据输入向量找到最相似的向量。类比考试答题:先到书上找相关内容,再结合题目组织答案。智能客服是 RAG 用得最广的场景。
场景 4:Fine-tuning(精调/微调)。类比努力学习考试内容,长期记住,活学活用。它的成本最高,应该放在前面几种方式解决不了问题之后再考虑。
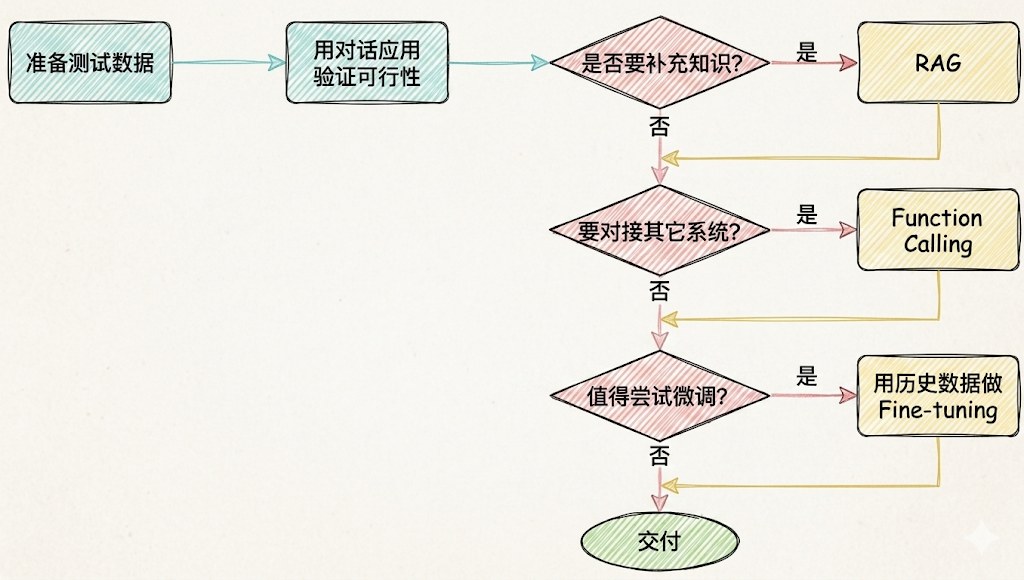
如何选择?面对一个需求,先准备测试数据,用对话应用验证可行性;然后按顺序判断:需要补充知识吗?需要就上 RAG;要对接其他系统吗?需要就用 Function Calling;值得尝试微调吗?只有历史数据足够、收益明确时才做 Fine-tuning;都不需要就直接交付。
05.4 系列小结
五篇到这里结束:LangChain 补足大模型缺的工具、数据与记忆;新项目直接用 v1.x;LangChain、LangGraph、Deep Agent、LangSmith 分层协作;环境用 conda 锁定 Python 3.13.12 与 langchain 1.2.12;落地形态从 Prompt、Function Calling、RAG 到 Fine-tuning 按需选择。
上一篇:开发前的环境准备;第一篇:为什么需要 LangChain。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。示例环境为 Python 3.13.12 + langchain 1.2.12。