前面几篇解决的都是输入侧的问题:模型怎么初始化、消息怎么组织、提示词怎么模板化。但不管输入多讲究,模型本身只会输出文本——它不知道今天的天气,算不准大数乘法,也读不到你数据库里的订单。Tools 补的就是这一环:让模型从「会说话」变成「会干活」。
17.1 只会生成文本,能力就到顶了
工具是赋予大语言模型「与外部世界交互能力」的关键组件。有了工具,智能体才能执行搜索、计算、数据库查询、发邮件、调用第三方 API 这类动作。一句话概括:没有工具,大模型只能认识世界;有了工具,它才开始改变世界。
课件里这张图把「工具」的典型形态列全了:搜索、计算器、数据库/文件读写、邮件与消息发送。
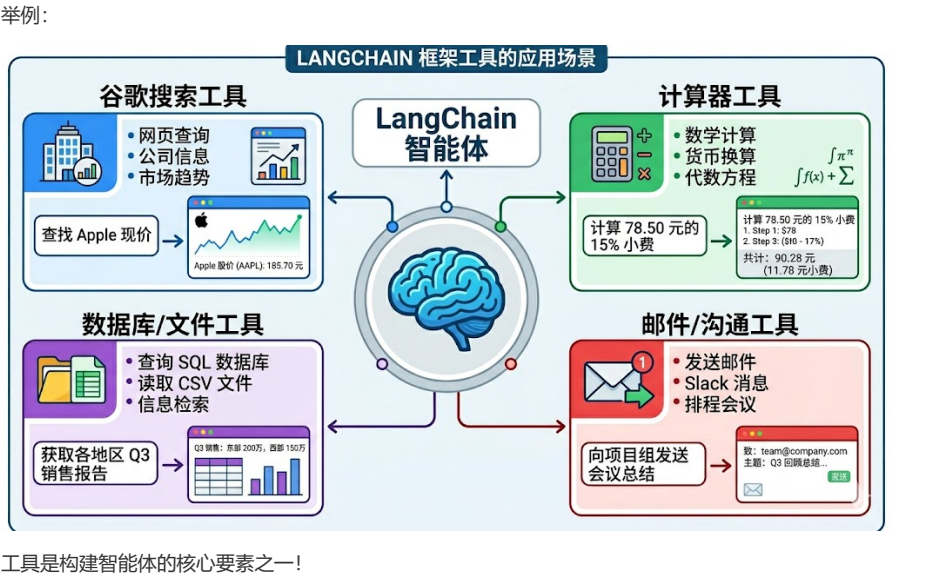
这也是工具被视为智能体核心要素的原因。一个只能输出文本的 Agent,本质上是个更贵的问答机器人:它能告诉你「应该查一下天气」,但没法自己查。
17.2 工具:明确定义了输入输出的可调用函数
在 LangChain 里,工具(Tools)不是某种特殊对象,而是一个明确声明了输入和输出的可调用函数。正因如此,工具调用(Tool Calling)在别处也叫函数调用(Function Calling)——两个词说的是同一件事。
调用方式有两种,用途完全不同。
方式 1:直接调用,用于测试。工具本身就是可调用对象,用 .invoke() 传一个字典即可。
from langchain_core.tools import tool

@tool
def get_weather(city: str) -> str:
    """
    获取指定城市的天气信息
    Args:
        city: 城市名称,如 "北京"、"上海"
    Returns:
        天气信息字符串
    """
    return city + "晴天,温度 15°C"

# 直接调用,入参是 dict,键名与参数名一致
result = get_weather.invoke({"city": "北京"})
print(result)
输出:
北京晴天,温度 15°C方式 2:绑定到模型,开发中的主流做法。用 bind_tools() 把工具交给模型,由模型自己决定要不要调、调哪个、参数填什么。这种方式下工具是给 AI 用的,不是给你手动调用的。
后续所有例子都基于同一段模型初始化:
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

load_dotenv(override=True)
model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)
初始化细节见 init_chat_model 统一初始化。
17.3 完整流程:四步,缺一不可
先看最小可运行版本:把工具绑上去,问一个需要天气的问题,看看模型返回什么。
from langchain_core.tools import tool

@tool
def get_weather(city: str) -> str:
    """获取指定城市的天气"""
    return "晴天,温度 15°C"

model_with_tools = model.bind_tools([get_weather])

response = model_with_tools.invoke("北京天气如何?")
# 换成 "2 + 3 = ?" 时,模型判断不需要工具
if response.tool_calls:
    print("AI 想调用工具:", response.tool_calls)
else:
    print("AI 直接回答:", response.content)
输出:
AI 想调用工具: [{'name': 'get_weather', 'args': {'city': '北京'},
  'id': 'call_fR3LE8Wjqh9lnDosQ61Y892E', 'type': 'tool_call'}]
注意此刻 response.content 是空的:模型只给了一个「调用请求」,没有执行任何函数。它把工具名、参数、调用 ID 一并发给你,接下来轮到你动手。所以真正能拿到最终答案的流程有四步:
| 步骤 | 谁做 | 做什么 |
|---|---|---|
| 1 绑定工具 | 开发者 | model.bind_tools([...]),一次可绑多个 |
| 2 生成调用请求 | 模型 | 需要工具时返回带 tool_calls 的 AIMessage |
| 3 执行工具 | 开发者 | 从 tool_calls 取名称和参数,真正调用函数 |
| 4 回传结果 | 开发者 + 模型 | 把结果包成 ToolMessage 塞回消息列表,再调一次模型生成最终回复 |
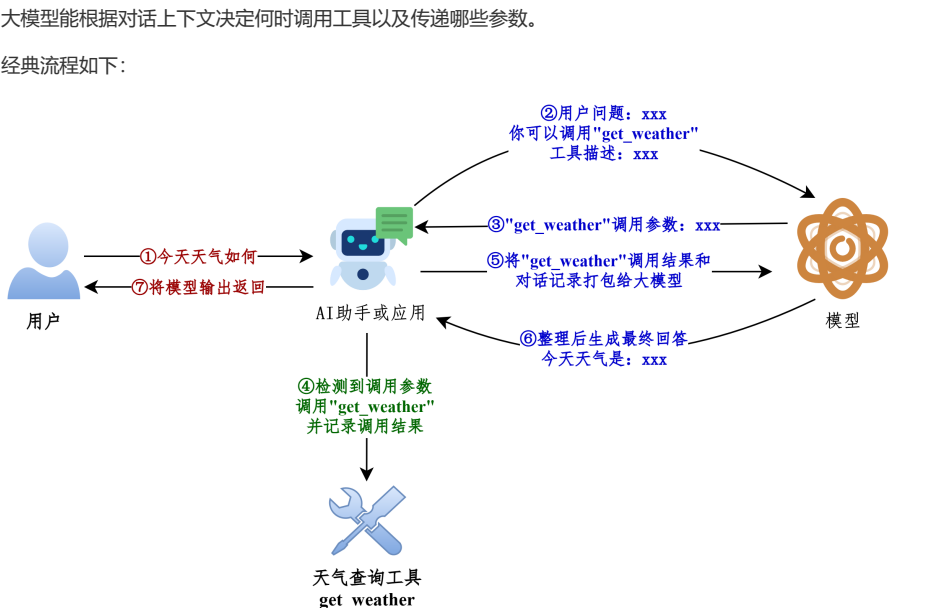
关键在于第 3 步:工具始终是开发者的代码在执行,模型不执行任何东西。模型负责「决定调用什么」和「读懂返回结果」,中间的搬运工作由你负责。
大模型调用工具是单次推理,一次请求给一个结果,不会自己循环。要连续调用多个工具,循环必须自己写——这部分在(十九)的多工具案例里展开。
17.4 从 Message 流转看工具调用
把上面四步拆到消息层面,整个过程就是消息列表的追加。课件里这张流程图把八个动作画全了:初始化模型与工具、创建 HumanMessage、调用模型、生成带 tool_calls 的 AIMessage、挂载 AI 响应、生成 ToolMessage、追加、最终响应。
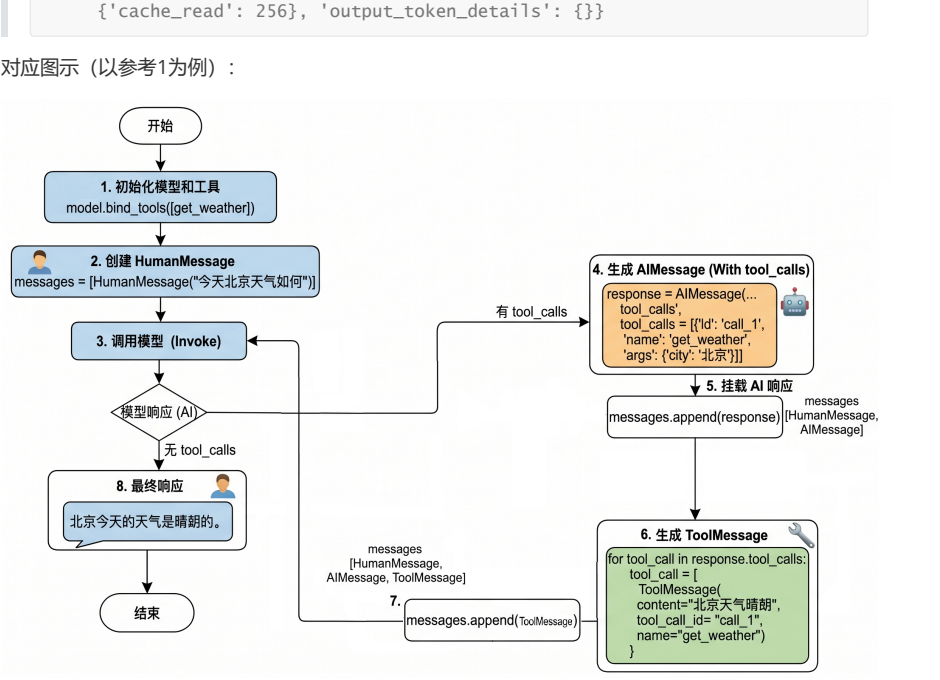
先看不使用 @tool 装饰的写法,此时工具只是一个普通函数:
from langchain.messages import HumanMessage, ToolMessage

def get_weather(city: str):
    """获取天气的工具"""
    return f"{city}天气晴朗"

model_with_tools = model.bind_tools([get_weather])
messages = [HumanMessage("今天北京天气如何")]

# 模型生成调用工具请求(AIMessage)
response = model_with_tools.invoke(messages)
messages.append(response)

# 开发者手动执行工具,并自己拼 ToolMessage
for tool_call in response.tool_calls:
    if tool_call["name"] == "get_weather":
        tool_response = ToolMessage(
            content=get_weather(**tool_call["args"]),
            tool_call_id=tool_call["id"],
            name=tool_call["name"],
        )
        messages.append(tool_response)

# 带着工具结果再问一次,模型才会给出自然语言回复
final_response = model_with_tools.invoke(messages)
print(final_response.content)
这段代码里最容易被忽略的是 tool_call_id:它必须与服务端返回的 tool_call["id"] 一致,模型靠这个 ID 把「我要的结果」和「你给的结果」对上。手拼出错,模型就会忽略这条 ToolMessage。
换成 @tool 修饰后,工具自己就能吃下整个 tool_call,直接吐一个 ToolMessage,不用再手工拼:
import os
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
from langchain_core.tools import tool
from langchain.messages import HumanMessage

load_dotenv(override=True)
model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)

@tool
def get_weather(city: str):
    """获取天气的工具"""
    return f"{city}天气晴朗~"

model_with_tools = model.bind_tools([get_weather])
messages = [HumanMessage("今天北京天气如何")]

response = model_with_tools.invoke(messages)
messages.append(response)

for tool_call in response.tool_calls:
    if tool_call["name"] == "get_weather":
        tool_response = get_weather.invoke(tool_call)   # 直接返回 ToolMessage
        print(type(tool_response))
        messages.append(tool_response)

for msg in messages:
    msg.pretty_print()

final_response = model_with_tools.invoke(messages)
print(final_response.content)
输出(截取关键部分):
<class 'langchain_core.messages.tool.ToolMessage'>
================================ Human Message ================================
今天北京天气如何
================================== Ai Message ==================================
好的,我来帮你查一下今天北京的天气情况。
Tool Calls:
  get_weather (call_00_f65kV4JKjBPK0HhURzO99449)
 Call ID: call_00_f65kV4JKjBPK0HhURzO99449
  Args:
    city: 北京
================================= Tool Message ==================================
Name: get_weather
北京天气晴朗~
今天北京天气 **晴朗** ☀,是个好天气,可以放心出门。
消息序列读起来就是一次完整的对话:人类提问 → AI 说要查天气并给出参数 → 工具返回结果 → AI 总结。调试时 pretty_print() 打一遍这个序列,比读任何日志都直观。
17.5 小结
这一篇只讲清楚了「工具是什么」和「调用怎么跑起来」:工具是声明了输入输出的可调用函数,调用方式分直接调用和绑定模型两种,完整流程是绑定、生成调用请求、执行、回传四步,模型永远只负责决策不负责执行。
但上面的工具描述都很随意——docstring 写了一行甚至没写。模型凭什么知道什么时候该调 get_weather?参数该填什么格式?下一篇讲工具的定义方式:docstring 的写法、@tool 的参数,以及用 Pydantic 和 JSON Schema 精确定义参数。
上一篇:提示词模板 ChatPromptTemplate 与高级用法;系列第一篇:为什么需要 LangChain。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。