这是 LangChain 1.2 系列的第一篇。先把三个问题说清楚:为什么只调用大模型 API 不够、LangChain 在系统里处于什么位置、它主要解决哪几类问题。
01.1 从传统应用到智能体时代
应用形态已经走过 PC 互联网和移动互联网两个阶段,现在进入 AI 智能化阶段。前两个阶段的应用流程由开发者预先写死:用户点哪个按钮、系统走哪条分支,都在代码里规定好。到了智能体阶段,应用把目标交给大模型,由模型判断下一步做什么,需要时再调用外部工具。
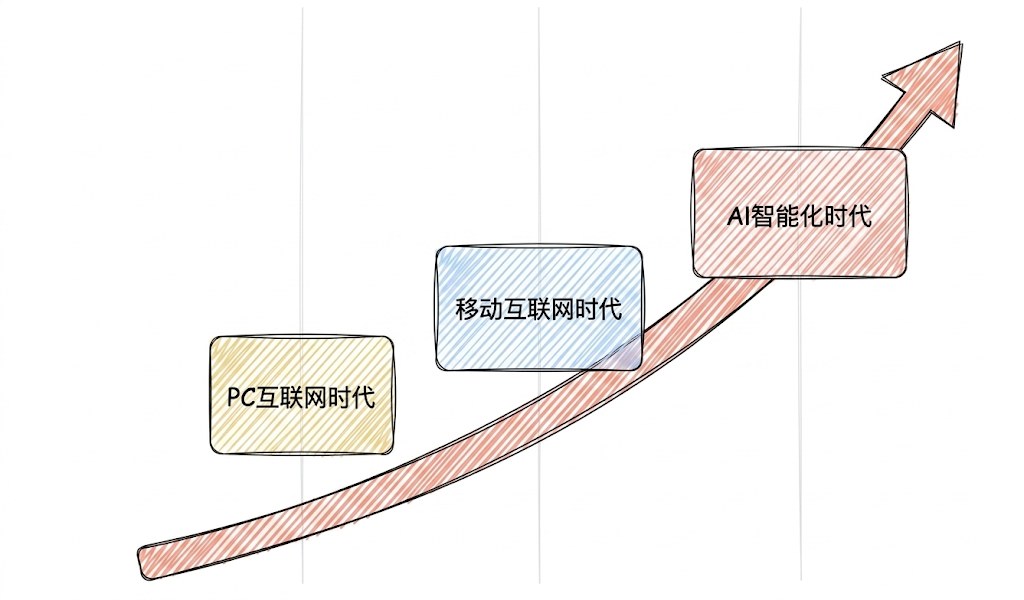
执行路径不再完全可枚举,系统就要额外处理模型输出、工具结果、上下文状态这些新问题。LangChain 接手的正是这一层工作。
01.2 单一的大语言模型有三个硬限制
只拿一个模型 API 做应用,很快会撞到三堵墙:
- 知识停在训练数据:模型不知道训练截止之后发生的事情,也读不到你的私有文档。问它最新的行情、公司内部制度,它只能猜。
- 碰不到外部系统:模型本身不能查数据库、不能调 API、不能读文件系统,实时数据和业务操作都与它隔绝。
- 记不住上下文:单次调用没有状态,多轮对话里用户前面说过的偏好、约束,下一轮就可能丢掉。
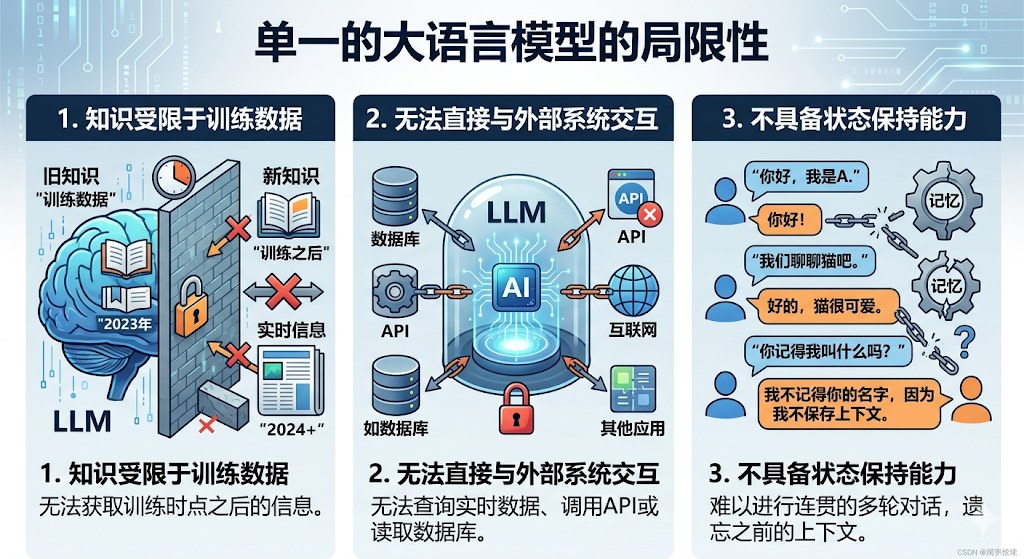
要把这三块补齐,就得给模型接上外部工具、数据源和记忆机制。LangChain 的设计理念,正是把这些能力组合成一个可复用的开发框架。
01.3 LangChain 的定位:模型与应用之间的中间层
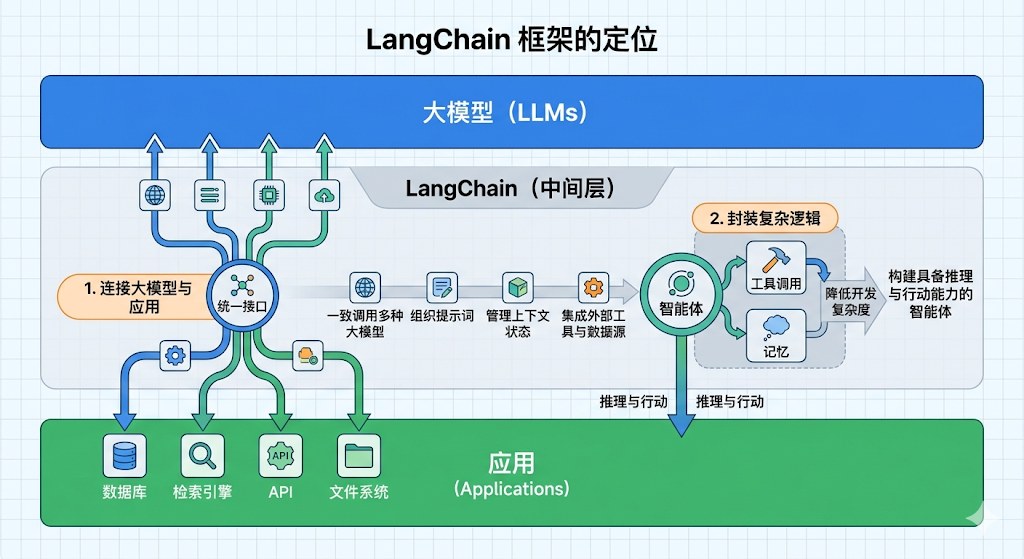
LangChain 不是模型,也不是最终应用,而是夹在两者之间的中间层。向上,它统一接入各种大模型,管理提示词和上下文;向下,它连接数据库、检索引擎、API、文件系统;中间,它把工具调用、记忆、智能体这些能力封装成统一抽象。
核心定位可以拆成三点:
- 打通大模型与外部资源:用统一接口对接数据库、检索引擎、API、文件系统等;
- 封装底层复杂逻辑:把工具调用、记忆等能力抽象出来,降低智能体开发难度;
- 支撑多智能体协作:依托 LangGraph 等生态,从单智能体扩展到多智能体协作,构建工业级系统。
01.4 六类典型应用场景
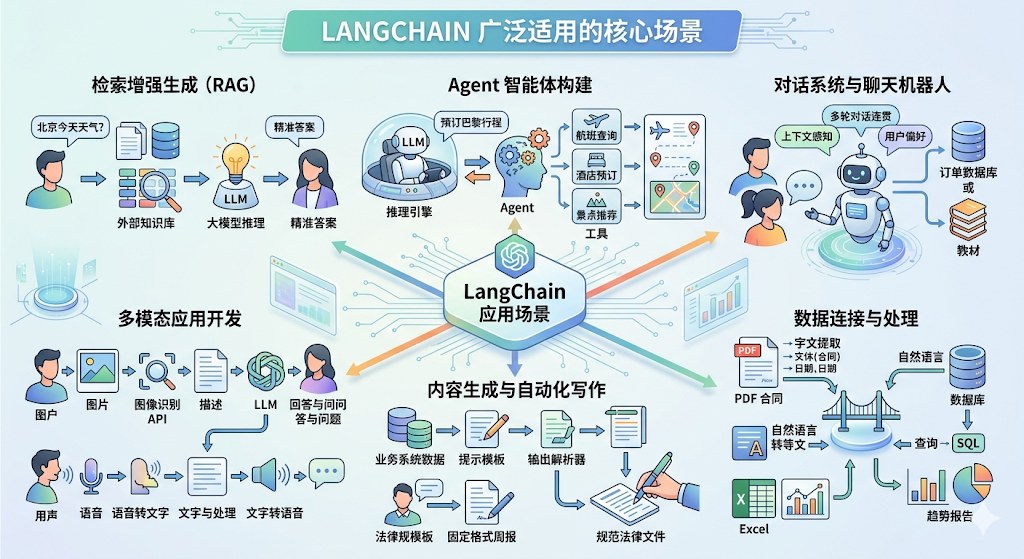
LangChain 的适用面很宽,但每类场景要解决的痛点并不相同:
| 场景 | 要解决的痛点 | 提供的能力 |
|---|---|---|
| 检索增强生成(RAG) | 模型知识滞后,缺少实时数据,容易产生幻觉 | 检索外部知识库(文档、数据库)并向量化,让模型基于最新、最相关的资料回答 |
| Agent 智能体 | LLM 无法直接执行复杂任务 | 把模型当作推理引擎,自主规划路径并动态调用外部工具,例如订票、查报告、写 SQL |
| 对话系统与聊天机器人 | 多轮对话中「记忆」流失 | 集成记忆管理,记住用户偏好和历史交互,并结合教材、订单库等私有数据提供专业服务 |
| 多模态应用 | 交互被限制在纯文本 | 融合图像识别、语音转文字等技术,让模型具备处理音视频和图片的综合推理能力 |
| 自动化写作与格式化生成 | 生成内容格式不标准、质量不稳定 | 配合提示词模板与输出解析器,自动产出规范的报告、合同或邮件 |
| 数据连接与结构化处理 | 非结构化数据难以被模型直接利用 | 从 PDF、Excel 中提取关键信息,或实现自然语言与 SQL 的自动转换 |
01.5 岗位地图:应用为王
大模型相关岗位可以按技术栈分层看。最上面是应用与 Agent 层,负责把模型能力做成产品和业务系统;往下依次是行业/多模态应用大模型层、通用大模型 Foundation 层、数据治理层,以及算力与 Infra 层。
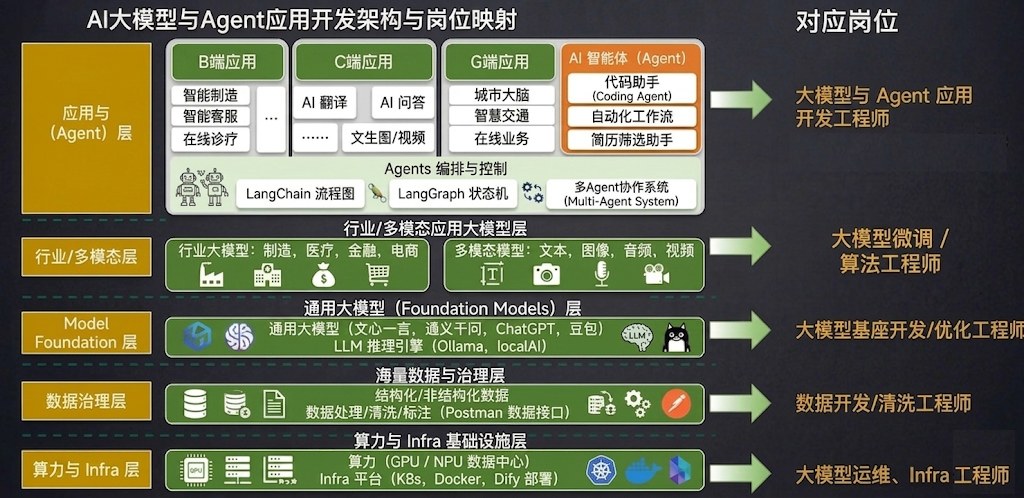
对应关系大致是:应用与 Agent 层对应「大模型与 Agent 应用开发工程师」;行业/多模态层对应「大模型微调 / 算法工程师」;Foundation 层对应「基座开发 / 优化工程师」;数据治理层对应「数据开发 / 清洗工程师」;算力与 Infra 层对应「大模型运维 / Infra 工程师」。
对大多数开发者来说,应用开发是投入产出比最高的切入点。LangChain 正好是这一层最常用的工具箱。
01.6 小结
这一篇只回答「为什么」:单靠模型 API,缺工具、缺数据、缺记忆;LangChain 用中间层把这些能力接起来;落地时先从应用与 Agent 开发切入。
下一篇进入具体内容:LangChain 1.2 入门(二):版本演进、包结构与 API 文档。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。