这是「AI 知识库系统」系列的第一篇,从零把向量化链路搭起来:引入依赖、配置向量存储、把切片写进 Qdrant、跑补偿任务。文中每个类都能直接用。
一、依赖
在 kb-service 的 pom.xml 里引入两个 starter:
<!-- EmbeddingModel 的 OpenAI 兼容实现:可指向任意兼容供应商

     (阶跃 / 智谱 / 通义 / 本地 Ollama 等) -->

<dependency>

    <groupId>org.springframework.ai</groupId>

    <artifactId>spring-ai-starter-model-openai</artifactId>

</dependency>


<!--

  向量存储 = Qdrant(spring.ai.vectorstore.type=qdrant):完全交给官方自动配置

  (QdrantVectorStoreAutoConfiguration + spring.ai.vectorstore.qdrant.*),

  本仓不声明自定义 bean,也不保留重复的配置类。


  选 Qdrant 的理由:自带持久化,且不像 Redis 那样要求实例带 search 模块 ——

  开发与生产是同一种形态。代价是新增一个有状态服务。

-->

<dependency>

    <groupId>org.springframework.ai</groupId>

    <artifactId>spring-ai-starter-vector-store-qdrant</artifactId>

</dependency>
为什么不自研 embedding 客户端?这个项目原本有个公共 AI 组件(只有 chat、没有 embedding),最直接的想法是给它补一个。但没这么做——那个组件是多个子系统共用的,为了知识库往里塞 embedding,等于让所有消费方被动承担一套他们没验证过的向量化实现。而 Spring AI 的 EmbeddingModel 已经封装了批量、重试、超时与多供应商支持,自研是纯重复劳动。
为什么用官方自动配置而不是自己写 Bean?因为自建 Bean 意味着要跟着 Spring AI 的版本演进持续维护。用官方 starter + 配置项,升级时只需要改配置。
二、配置
spring:

  ai:

    # 向量模型:指向 OpenAI 兼容供应商(这里用本机 Ollama)

    openai:

      embedding:

        base-url: http://localhost:11434/v1

        api-key: dummy            # Ollama 不校验,但不能为空

        options:

          model: bge-m3

    # 向量存储:交给官方自动配置

    vectorstore:

      type: qdrant

      qdrant:

        host: 127.0.0.1

        port: 6334                # gRPC 端口

        collection-name: kb_chunk_idx

        initialize-schema: true   # 首次启动自动建集合


# 知识库业务参数(与连接配置分开:这些是业务上限,不是连接信息)

kb:

  embedding:

    # 向量化的业务参数;供应商连接走 spring.ai.openai.embedding.*

    batch-size: 64

    # 实测:单次扫描跑满 SCAN_BATCH_SIZE(200) 条就停,然后干等到下一个 cron 触发点。

    # 一次约 14 秒/批(16 条、约 450 tokens/s,是本机硬件上限),所以间隔就是吞吐的大头:

    # 3 分钟间隔 ≈ 一半时间在空等。置 30 秒后,重叠由 ShedLock 兜住。

    scan-cron: 0/30 * * * * ?
一个必须注意的操作纪律:多个环境共用同一个 Qdrant 实例时,集合名必须分开(开发用 kb_chunk_idx_dev)。因为切片 id 来自各自的数据库、自增序列彼此独立,同名集合里两边会互相覆盖——而且不报错,只是答案逐渐变错。
三、可用性判断:不要直接注入
@Service

@RequiredArgsConstructor

public class KbVectorServiceImpl implements KbVectorService {


    private final ObjectProvider<EmbeddingModel> embeddingModelProvider;

    private final ObjectProvider<VectorStore> vectorStoreProvider;


    /** 当前向量模型标识(会冗余写进知识库),取值即 Spring AI 的模型配置项 */

    @Value("${spring.ai.openai.embedding.options.model:}")

    private String embeddingModelName;


    @Override

    public boolean available() {

        // 容器里同时有 EmbeddingModel 与 VectorStore 才算可用:两者都由

        // spring.ai.model.embedding=openai 这个开关驱动(Spring AI 1.1 的模型选择机制)。

        // 用 ObjectProvider 而不是直接注入:未启用时这两个 bean 不存在,

        // 直接注入会让应用启动失败。

        return embeddingModelProvider.getIfAvailable() != null

                && vectorStoreProvider.getIfAvailable() != null;

    }


    @Override

    public String unavailableReason() {

        if (embeddingModelProvider.getIfAvailable() == null) {

            return "未启用向量模型(把 spring.ai.model.embedding 设为 openai,并配置 spring.ai.openai.*)";

        }

        if (vectorStoreProvider.getIfAvailable() == null) {

            return "未装配向量存储(检查 spring.ai.vectorstore.type 与对应连接配置)";

        }

        return "";

    }

}
用 ObjectProvider 是必须的。如果没有配置 AI,这两个 bean 根本不存在,直接 @Autowired 会让整个应用启动失败——等于”没配 AI 就用不了知识库”。
而 unavailableReason() 返回的是可操作的提示,不是”服务不可用”这种废话。使用者能直接照着改配置。
3.1 维度:别以为写了就锁住了
@Override

public Integer currentDimensions() {

    EmbeddingModel embeddingModel = embeddingModelProvider.getIfAvailable();

    if (embeddingModel == null) {

        return null;

    }

    try {

        return embeddingModel.dimensions();

    } catch (Exception e) {

        // 部分实现不提供维度自报(默认实现会抛 UnsupportedOperationException)。

        // 这时留空即可:dim 只是冗余记录,不参与检索判断。

        log.debug("当前向量模型不支持自报维度:{}", e.getMessage());

        return null;

    }

}
关于维度有个容易误解的地方:Spring AI 1.1.2 的 EmbeddingModel.dimensions() 是接口默认方法——它实际发一次测试请求,用返回数组的长度作为维度。而配置项 spring.ai.openai.embedding.options.dimensions 是否生效取决于模型本身:bge-m3 直接忽略它,而 qwen3-embedding 会按它截断(实测设 512 就真的变成 512 维)。
结论:以为写了 dimensions 就锁住维度是个错觉。换模型后维度仍会变,仍必须删集合重建。
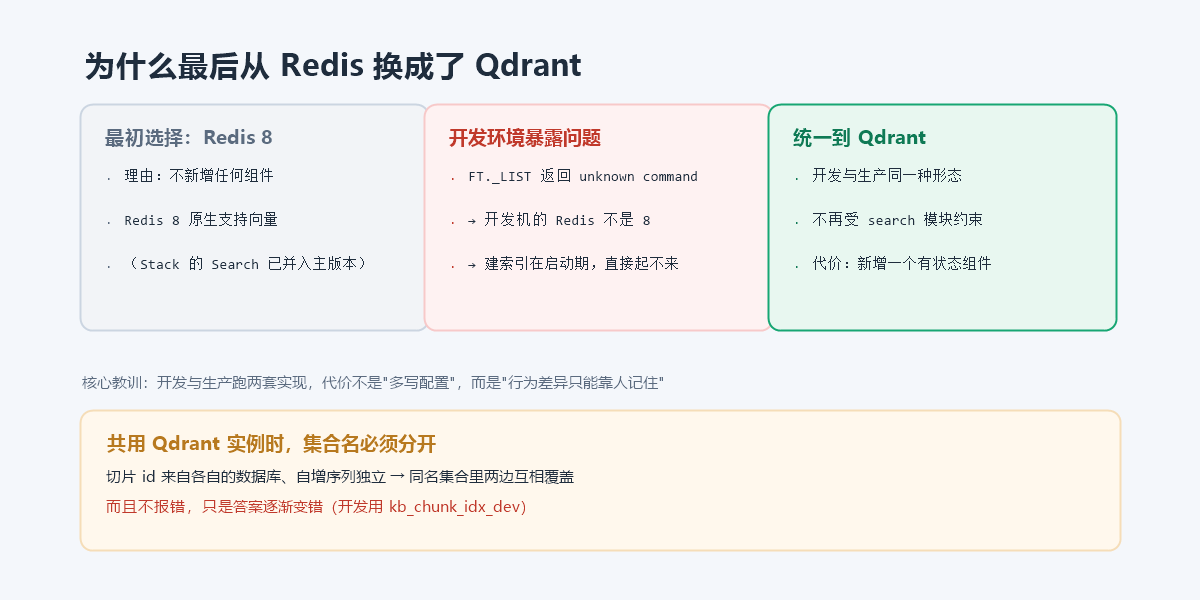
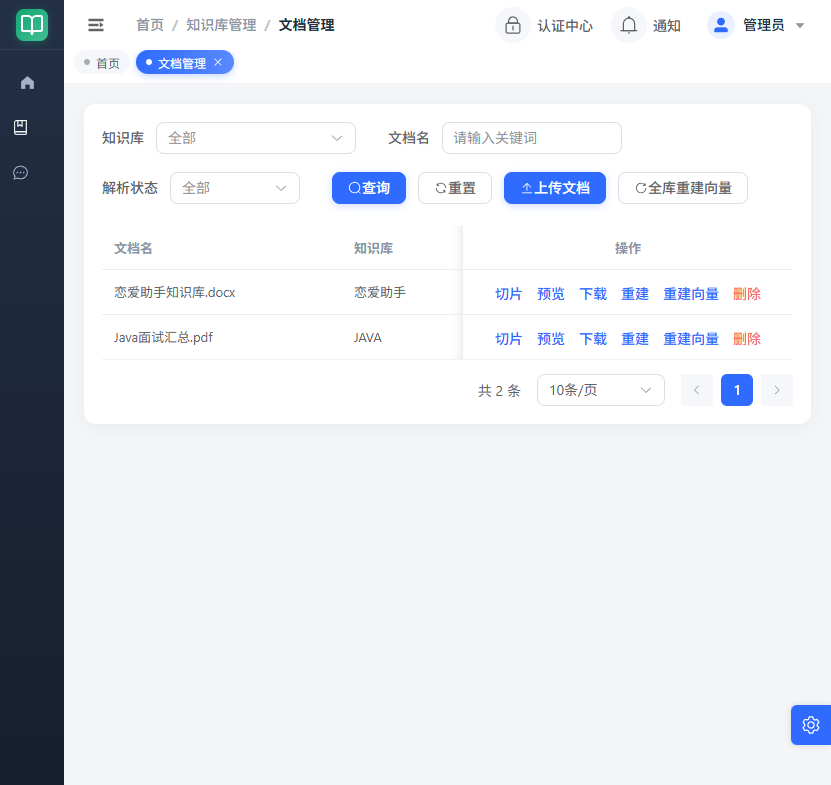
图:文档管理,上传后可切片、预览、重建。
四、切片写入向量库
4.1 点 ID 必须转成 UUID
这是整套代码里最容易踩坑的地方:
/**

 * 切片主键 → 向量库里的点 ID。

 *

 * <p><b>为什么不能直接用切片主键</b>:Spring AI 1.1.2 的 QdrantVectorStore 在写入与删除时

 * 都直接 UUID.fromString(document.getId()),<b>根本没有数字分支</b>

 * (javap 看过字节码:doAdd 与 doDelete 各一处)。而 Qdrant 的点 ID 只接受

 * 「无符号整数」或「合法 UUID」—— Spring AI 这条路径只走 UUID,

 * 所以传 "231" 会抛 IllegalArgumentException: Invalid UUID string: 231。</p>

 *

 * <p>用 nameUUIDFromBytes 由主键推导(v3 UUID),<b>确定性是这里的要害</b>:

 * 同一个切片无论重算多少次都落到同一个点,所以「重建向量」是覆盖而不是产生重复点,

 * 删除也能靠它精确定位;同时 vector_id 仍与 chunk_id 一一对应,

 * 不需要额外的映射表。</p>

 *

 * <p>换向量存储实现(如二期 Milvus)时这一层要重看 —— 它是「本仓的 ID 约定」与

 * 「存储实现的要求」耦合的地方。改算法等于换点 ID,旧向量全部对不上,必须全库重建。</p>

 */

static String pointIdOf(Long chunkId) {

    return UUID.nameUUIDFromBytes(("kb-chunk:" + chunkId).getBytes(StandardCharsets.UTF_8)).toString();

}
为什么要加 "kb-chunk:" 前缀?避免与其它类型的 ID 推导出相同的 UUID。命名空间隔离,成本几乎为零。
4.2 Document 的构造
private Document toDocument(KbChunkEntity chunk) {

    Map<String, Object> metadata = new HashMap<>(5);

    if (chunk.getTenantId() != null) {

        metadata.put(KbConstants.META_TENANT_ID, String.valueOf(chunk.getTenantId()));

    }

    if (chunk.getBaseId() != null) {

        metadata.put(KbConstants.META_BASE_ID, String.valueOf(chunk.getBaseId()));

    }

    if (chunk.getDocId() != null) {

        metadata.put(KbConstants.META_DOC_ID, String.valueOf(chunk.getDocId()));

    }

    metadata.put(KbConstants.META_CHUNK_ID, String.valueOf(chunk.getId()));

    if (chunk.getVersion() != null) {

        metadata.put(KbConstants.META_VERSION, chunk.getVersion());

    }

    return Document.builder()

            // id 必须走 pointIdOf:Qdrant 那边只认 UUID,直接塞切片主键会抛

            // Invalid UUID string: 231。

            // 注意与下面的 metadata.chunkId 分工:metadata 里保持数字主键

            // (检索端按 Long 解析回查),点 ID 才是 UUID —— 两者用途不同,别合并。

            .id(pointIdOf(chunk.getId()))

            .text(chunk.getContent())

            .metadata(metadata)

            .build();

}
点 ID 是 UUID,metadata 里存的是数字主键——这两者用途完全不同,不能合并:点 ID 是给 Qdrant 用的,metadata 是给业务回查用的(检索时按 Long 解析,用于过滤和关联 MySQL)。
4.3 批量向量化
@Override

public int embedChunks(List<KbChunkEntity> chunks) {

    if (chunks == null || chunks.isEmpty() || !available()) {

        return 0;

    }

    int batchSize = Math.max(1, embeddingProperties.getBatchSize());

    int success = 0;

    for (int from = 0; from < chunks.size(); from += batchSize) {

        List<KbChunkEntity> batch = chunks.subList(from, Math.min(from + batchSize, chunks.size()));

        long startedAt = System.currentTimeMillis();

        try {

            embedBatch(batch);

            markStatus(batch, KbConstants.EMBED_STATUS_SUCCESS);

            success += batch.size();

            recordInvoke(batch, true, null, startedAt);

        } catch (Exception e) {

            log.warn("切片向量化失败:size={}", batch.size(), e);

            markStatus(batch, KbConstants.EMBED_STATUS_FAILED);

            // 失败也记流水:请求已经发出,多数供应商照样计费

            recordInvoke(batch, false, e.getMessage(), startedAt);

        }

    }

    // 文档级状态必须在这里回写:kb_document.embed_status 是列表页「向量化」那一列的数据源,

    // 而全仓只有本类知道切片的向量化结果 —— 不在这里对齐,那一列会永远停在「待向量化」,

    // 表现成「文档传完了却一直没向量化」,实际上向量早就算好了。

    refreshDocumentEmbedStatus(chunks);

    return success;

}


private void embedBatch(List<KbChunkEntity> batch) {

    VectorStore vectorStore = vectorStoreProvider.getObject();

    List<Document> documents = new ArrayList<>(batch.size());

    for (KbChunkEntity chunk : batch) {

        documents.add(toDocument(chunk));

    }

    // 向量由 VectorStore 内部调用 EmbeddingModel 计算(EMBED 模式只看正文)

    vectorStore.add(documents);

}
两个设计点:
① 批内失败不影响其它批。某批超时就标记失败,继续下一批。整批回滚会让一次网络抖动毁掉几百条切片。
② 失败也记流水。请求已经发出去了,多数供应商照样计费——那些”花了钱没拿到东西”的调用最需要被看见。
③ 文档状态必须在这里回写。这是注释里特意强调的:kb_document.embed_status 是列表页那一列的数据源,而只有这一层知道切片的向量化结果。不回写的话,页面上永远显示”待向量化”,使用者会以为功能没生效。
4.4 状态回填要用「只更新必要字段」
/**

 * 回填向量化状态。

 *

 * <p>只设 id + 状态 + vector_id:其余字段为 null,MP 的默认更新策略(NOT_NULL)

 * 不会覆盖它们 —— 也就不会把 tenant_id 之类抹掉。</p>

 */

private void markStatus(List<KbChunkEntity> batch, int status) {

    boolean success = status == KbConstants.EMBED_STATUS_SUCCESS;

    List<KbChunkEntity> updates = new ArrayList<>(batch.size());

    for (KbChunkEntity chunk : batch) {

        KbChunkEntity update = new KbChunkEntity();

        update.setId(chunk.getId());

        update.setEmbedStatus(status);

        if (success) {

            // 与 Document.id 保持同一个换算(pointIdOf):这个字段是「向量库里那条记录」的

            // 外键,删向量与离线对账都靠它,写错就等于对不上账

            update.setVectorId(pointIdOf(chunk.getId()));

        }

        updates.add(update);

    }

    updateBatchById(updates);

}构造新对象而不是复用原对象是关键:MyBatis-Plus 的默认更新策略是 NOT_NULL,只更新非 null 字段。如果直接把查询出来的实体改一改再更新,会把 tenant_id 之类一起写回去——看似无害,但如果中间有其他线程改过这些字段,就会覆盖掉。
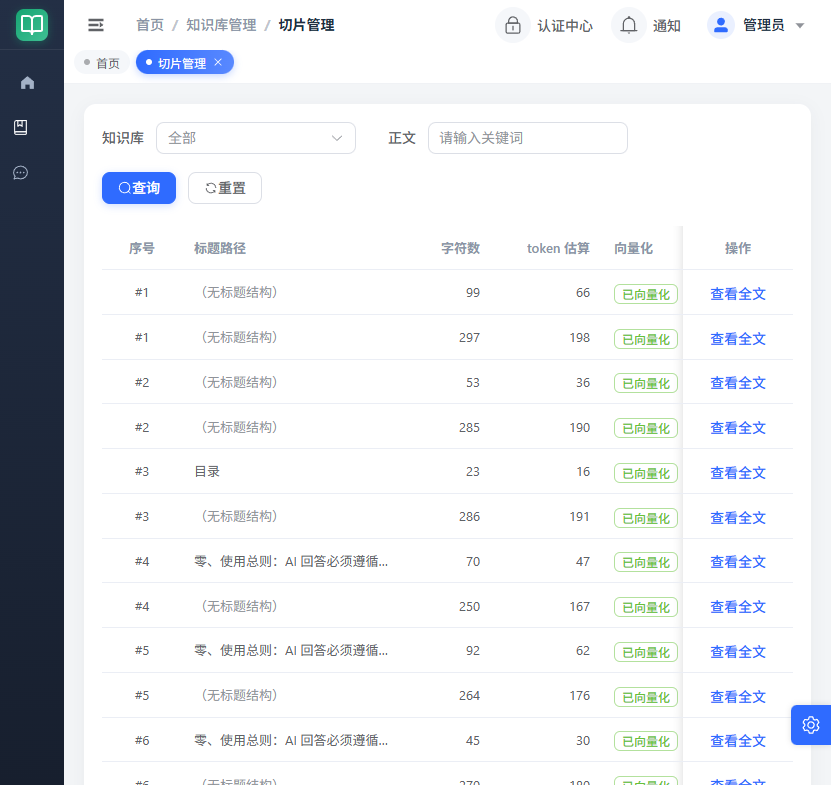
图:切片管理,每条切片的字符数、token 估算与向量化状态。
五、补偿任务:扫待向量化的切片
@Override

public int embedPending() {

    if (!available()) {

        // 未启用时直接空转,且不打日志:定时任务每几分钟跑一次,刷日志只会淹没真实告警

        return 0;

    }

    List<KbChunkEntity> candidates = kbChunkMapper.selectList(Wrappers.<KbChunkEntity>lambdaQuery()

            .eq(KbChunkEntity::getEmbedStatus, KbConstants.EMBED_STATUS_PENDING)

            .orderByAsc(KbChunkEntity::getId)

            .last("LIMIT " + SCAN_BATCH_SIZE));

    if (candidates.isEmpty()) {

        return 0;

    }

    // 定时任务里没有登录用户,租户上下文为空 —— 租户拦截器因此不过滤,

    // 正好能扫到所有租户的待向量化切片。这是刻意的:补偿任务本就要跨租户工作。

    //

    // 但正因如此,配额必须按切片自身的租户判断,不能用「当前上下文」。

    // 额度用尽的租户直接跳过它的切片:不能抛异常 —— 那会让整个补偿任务失败,

    // 其他租户的切片跟着一起积压。

    Map<Long, Boolean> allowedByTenant = new HashMap<>();

    List<KbChunkEntity> allowed = new ArrayList<>(candidates.size());

    for (KbChunkEntity chunk : candidates) {

        boolean canEmbed = allowedByTenant.computeIfAbsent(chunk.getTenantId(),

                kbTenantQuotaService::canEmbed);

        if (canEmbed) {

            allowed.add(chunk);

        }

    }

    if (allowed.isEmpty()) {

        return 0;

    }

    return embedChunks(allowed);

}
这段代码有三层考量:
① 定时任务里租户上下文为空,拦截器因此不过滤——正好能扫到所有租户。这是刻意的,补偿任务本就该跨租户工作。
② 配额要按切片自身的租户判断,不能用”当前上下文”(那是空的)。所以按 tenantId 缓存判断结果,避免同租户的切片反复查库。
③ 额度用尽的租户跳过,不能抛异常。抛异常会让整个补偿任务失败,其他租户的切片跟着一起积压。
5.1 定时任务注册
@Scheduled(cron = "${kb.embedding.scan-cron}")

@SchedulerLock(name = "kbEmbedPendingScan", lockAtLeastFor = "20s", lockAtMostFor = "10m")

public void scanEmbedding() {

    int done = kbVectorService.embedPending();

    if (done > 0) {

        log.info("向量化补偿完成:{} 条", done);

    }

}
用 ShedLock 保证多实例只有一个在跑。注意 lockAtLeastFor——它能防止多个实例”接力”执行(一个刚释放,另一个立刻抢到),避免同一批切片被反复处理。
六、重建向量的入口
POST /kb/doc/reembed/{id}       单份文档

POST /kb/base/reembed/{id} 整个知识库接口语义是只做「置回待向量化」并立即返回,实际向量化由补偿任务推进(最坏 30 秒)。所以提示语必须是「已提交 N 条」而不是「已完成」——这个措辞差异很重要,否则使用者会以为已经算完了。
切换向量存储实现时有个容易漏的动作:新存储里一条向量都没有,而切片的 embed_status 仍是「已向量化」,补偿任务不会自动重算。于是检索静默退化为纯关键词——症状就是「能用,但语义问答答不准」。切完必须手动触发一次重建。
七、小结
这一篇的要点:
- 用
ObjectProvider而不是直接注入——没配 AI 时应用仍能启动,只是功能显示”未启用” - 点 ID 必须转 UUID——Spring AI 的 Qdrant 实现只有 UUID 分支,传数字主键会直接抛异常
- UUID 推导必须确定性(
nameUUIDFromBytes)——这样重建是覆盖而不是产生重复点 - 补偿任务跨租户工作,配额按切片自身租户判断——配额用尽跳过而非抛错
以及一条从环境差异中得出的教训:开发和生产跑不同的存储实现,代价不是”多写一套配置”,而是”行为差异只能靠人记住”。这个项目最终统一到 Qdrant,多了一个组件,但换来了形态一致。
下一篇讲文档解析与切片:怎么把 docx / pdf / xlsx 变成可向量化的切片。