这一篇实现从「切片入库」到「双路召回融合」的完整链路。核心是一个容易被忽略的设计:为什么必须保留关键词召回。
一、切片入库
@Override

@Transactional(rollbackFor = Exception.class)

public void replaceChunks(Long docId, Integer version, List<KbChunkDraft> drafts) {

    // 重建时先清掉同版本旧切片,保证 replace 语义

    remove(Wrappers.<KbChunkEntity>lambdaQuery()

            .eq(KbChunkEntity::getDocId, docId)

            .eq(KbChunkEntity::getVersion, version));

    if (drafts == null || drafts.isEmpty()) {

        return;

    }


    KbDocumentEntity document = kbDocumentMapper.selectById(docId);

    Long baseId = document == null ? null : document.getBaseId();

    // 租户归属必须从文档继承,不能指望基类从上下文回填:

    // 解析补偿任务(KbParseTask)跑在无请求上下文的调度线程里,

    // UserUtils.getTenantId() 为 null,而 fillTenantId(null) 是「保留原值」语义

    // —— 结果是切片 tenant_id 留空。

    // 那样的文档看起来解析成功(parse_status=2、chunk_count>0),

    // 但检索带 tenant_id 条件,永远召不回它;再解析一次还会撞上 uk_doc_version_chunk。

    Long tenantId = document == null ? null : document.getTenantId();


    List<KbChunkEntity> entities = new ArrayList<>(drafts.size());

    for (KbChunkDraft draft : drafts) {

        KbChunkEntity entity = new KbChunkEntity();

        entity.setTenantId(tenantId);

        entity.setBaseId(baseId);

        entity.setDocId(docId);

        entity.setVersion(version);

        entity.setChunkNo(draft.chunkNo());

        entity.setTitlePath(draft.titlePath());

        entity.setContent(draft.content());

        // 内容哈希:同租户内相同内容不重复向量化(embedding 成本的第一道节流阀)

        entity.setContentHash(DigestUtil.sha256Hex(draft.content()));

        entity.setCharCount(draft.charCount());

        entity.setTokenCount(draft.tokenCount());

        entity.setEmbedStatus(KbConstants.EMBED_STATUS_PENDING);

        entities.add(entity);

    }

    saveBatch(entities);

}「租户必须从文档继承」这段注释值得细读,因为它描述了一个很难排查的故障:
解析任务跑在调度线程里,没有请求上下文,UserUtils.getTenantId() 返回 null。而基础类里的 fillTenantId(null) 语义是「保留原值」(不是”设为 null”),结果切片的 tenant_id 就留空了。
症状是:文档看起来解析成功(状态正常、切片数正确),但检索永远召不回它——因为检索会带 tenant_id 条件。更麻烦的是重新解析还会撞上 uk_doc_version_chunk 唯一键。
1.1 重建时的状态重置
@Override

public int resetEmbedPending(Long docId, Integer version) {

    return baseMapper.update(null, Wrappers.<KbChunkEntity>lambdaUpdate()

            .eq(KbChunkEntity::getDocId, docId)

            .eq(KbChunkEntity::getVersion, version)

            // 已经待向量化的不必再写:这个条件同时让「重置」是幂等的

            .ne(KbChunkEntity::getEmbedStatus, KbConstants.EMBED_STATUS_PENDING)

            .set(KbChunkEntity::getEmbedStatus, KbConstants.EMBED_STATUS_PENDING)

            // vector_id 的语义是「向量存储里已经有这条」:必须一起清掉。

            // 留着它会在离线对账时谎报「向量还在」,而实际上已经要重算了。

            .set(KbChunkEntity::getVectorId, null));

}
vector_id 必须一起清掉——它表示”向量库里已经有这条”。如果不清,离线对账时会谎报”向量还在”,而实际上已经标记为要重算了。
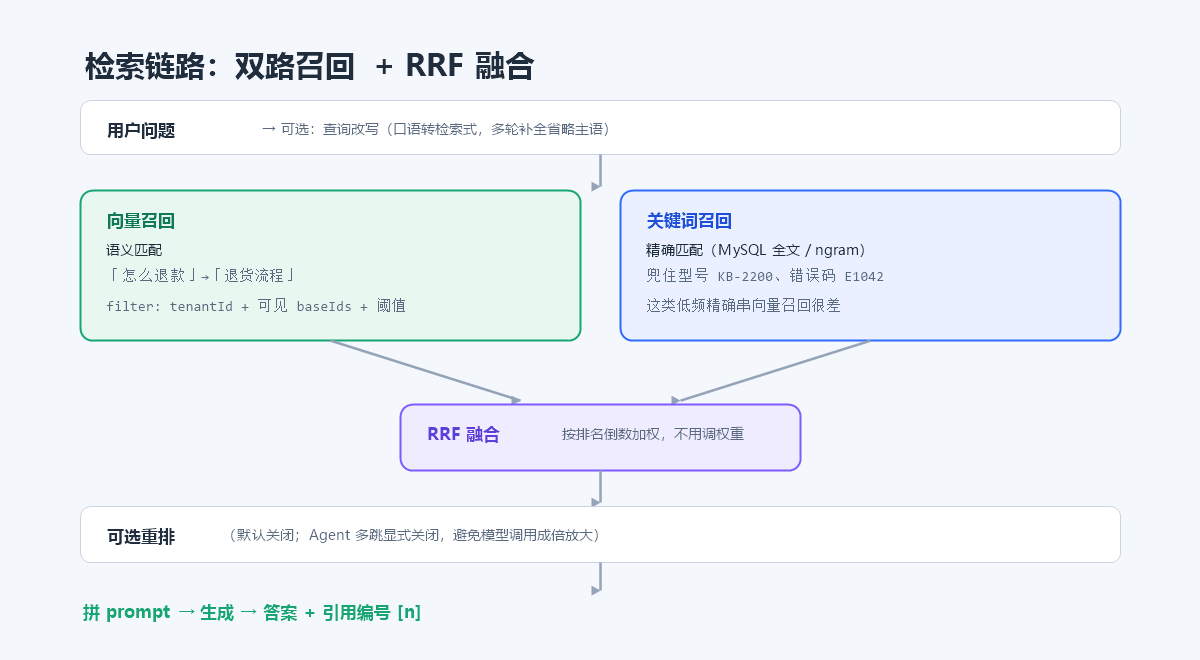
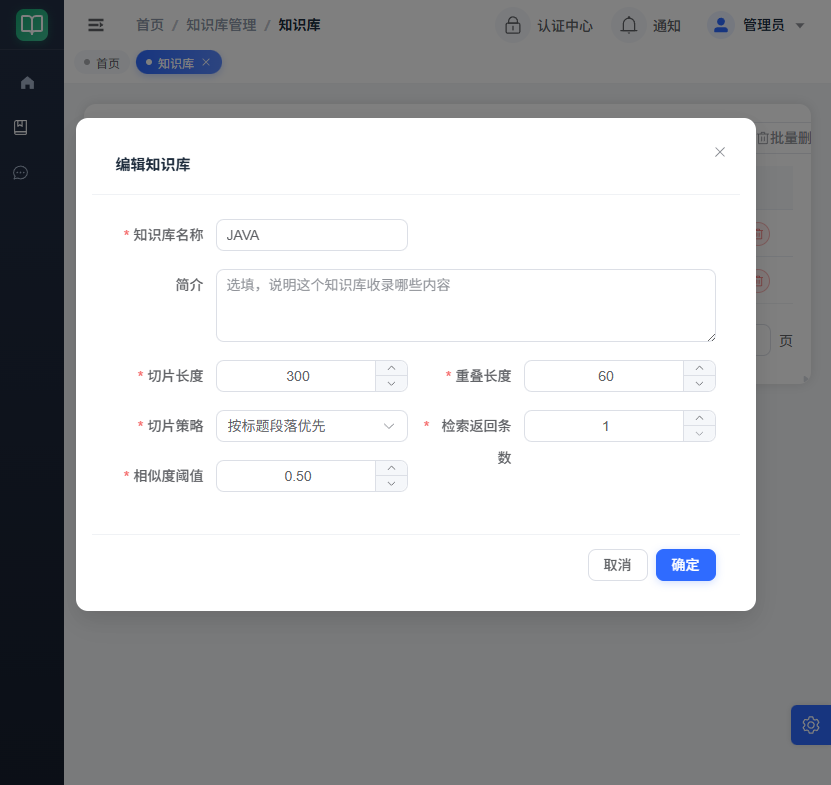
图:知识库参数,切片长度、重叠、检索返回条数与相似度阈值。
二、检索链路总览
@Override

public List<KbRetrievalHit> retrieve(KbRetrievalQuery query) {

    if (query == null || StrUtil.isBlank(query.getQuestion())) {

        return List.of();

    }

    int topK = query.getTopK() != null && query.getTopK() > 0

            ? query.getTopK()

            : properties.getFinalTopK();

    long startedAt = System.currentTimeMillis();


    // 两路并行召回

    Map<Long, Double> vectorHits = vectorCandidates(query);

    Map<Long, Double> keywordHits = keywordCandidates(query);

    if (vectorHits.isEmpty() && keywordHits.isEmpty()) {

        return List.of();

    }


    // 重排要先在更大的候选集上做:只给最终 topK 条重新排序,

    // 等于没解决「该靠前的没被召回」

    boolean rerank = query.getRerank() != null

            ? query.getRerank()

            : properties.getRerank().isEnabled();

    int candidateLimit = rerank

            ? Math.max(topK, Math.max(1, properties.getRerank().getCandidates()))

            : topK;


    // RRF 融合后按得分倒序取候选

    Map<Long, Double> fused = fuse(vectorHits, keywordHits);

    List<Long> ordered = fused.entrySet().stream()

            .sorted(Map.Entry.<Long, Double>comparingByValue().reversed())

            .limit(candidateLimit)

            .map(Map.Entry::getKey)

            .toList();


    List<KbRetrievalHit> hits = assemble(ordered, fused, vectorHits, keywordHits);

    if (rerank && hits.size() > 1) {

        // 重排永不抛出:失败时返回原顺序

        hits = kbRerankService.rerank(query.getQuestion(), hits);

    }

    List<KbRetrievalHit> result = hits.size() > topK ? new ArrayList<>(hits.subList(0, topK)) : hits;

    log.info("检索完成:question={},向量={},关键词={},融合={},重排={},最终={},耗时={}ms",

            StrUtil.maxLength(query.getQuestion(), 50),

            vectorHits.size(), keywordHits.size(), fused.size(),

            hits.size(), result.size(), System.currentTimeMillis() - startedAt);

    return result;

}
对应配置:
kb:

  retrieval:

    vector-top-k: 20      # 向量路召回条数

    keyword-top-k: 20     # 关键词路召回条数

    final-top-k: 8        # 最终送入模型的条数

    rrf-k: 60             # RRF 平滑常数(论文取值),别随手调

    min-similarity: 0.5   # 相似度下限:0 = 不过滤

    max-chars-per-chunk: 800

    rerank:

      enabled: false      # 默认关闭

      candidates: 20      # 必须 >= final-top-k
三、向量路召回
/**

 * 向量路召回。

 *

 * <p>失败只降级、不抛出:向量服务抖动或供应商超时不该让整个问答 500,

 * 关键词路仍能给出可用结果。降级会打 WARN,便于从日志发现。</p>

 */

private Map<Long, Double> vectorCandidates(KbRetrievalQuery query) {

    VectorStore vectorStore = vectorStoreProvider.getIfAvailable();

    if (vectorStore == null) {

        return Map.of();

    }

    try {

        SearchRequest request = SearchRequest.builder()

                .query(query.getQuestion())

                .topK(Math.max(1, properties.getVectorTopK()))

                // 知识库级阈值优先,全局值兜底

                .similarityThreshold(query.getMinSimilarity() != null

                        ? query.getMinSimilarity()

                        : properties.getMinSimilarity())

                .filterExpression(buildFilterExpression(query))

                .build();


        Map<Long, Double> hits = new LinkedHashMap<>();

        for (Document document : vectorStore.similaritySearch(request)) {

            Long chunkId = parseChunkId(document);

            if (chunkId != null) {

                // 同一切片理论上不会重复,去重只为防御性保序

                hits.putIfAbsent(chunkId, document.getScore() == null ? 0D : document.getScore());

            }

        }

        return hits;

    } catch (Exception e) {

        log.warn("向量召回失败,本次降级为纯关键词召回:{}", e.getMessage());

        return Map.of();

    }

}失败即降级,不抛异常。向量服务抖动或供应商超时不该让整个问答接口 500——关键词路仍能给出可用结果,而且降级会打 WARN,运维能从日志发现。
四、关键词路召回
<select id="searchIdsByKeyword" resultType="com.laijun.kb.retrieval.KbChunkScore">

    SELECT c.`id`            AS chunkId,

           MATCH(c.`content`) AGAINST (#{keyword}) AS score

    FROM kb_chunk c

    WHERE MATCH(c.`content`) AGAINST (#{keyword})

    <if test="baseIds != null and baseIds.size() > 0">

        AND c.`base_id` IN

        <foreach collection="baseIds" item="baseId" open="(" separator="," close=")">

            #{baseId}

        </foreach>

    </if>

    ORDER BY score DESC

    LIMIT #{limit}

</select>
这段 SQL 有四条注释值得逐条看:
① 只 SELECT id 与得分,不 SELECT content。召回阶段只需要排名。正文可能有数千字符,全查回来再丢掉大部分候选是纯浪费。正文留到按 topK 回查时一并取出(顺带完成租户与版本的二次校验)。
② SQL 里看不到 tenant_id,这是刻意的。kb_chunk 已登记在租户隔离表里,条件由拦截器注入。如果这里手写租户条件,反而说明拦截器没覆盖到这张表——那才是真正需要修的地方。
③ 排序表达式与 WHERE 里的 MATCH 必须完全一致(同样的列、同样的模式),否则 MySQL 不会复用同一个全文索引,ORDER BY 会退化成文件排序。
④ 用到 ngram 全文索引,建表时需要:
ALTER TABLE kb_chunk ADD FULLTEXT INDEX ft_chunk_content (content) WITH PARSER ngram;4.1 阈值是「相对强度」,不是绝对相似度
/**

 * 关键词路召回(MySQL ngram 全文索引)。

 *

 * <p><b>这里的阈值是「相对强度」,不是「绝对相似度」</b>:BM25 得分没有固定量纲

 * (实测同一个库里既可能 0.5 也可能 10+,随语料与分词漂移),与向量余弦的 0~1

 * 不是一回事,直接拿阈值去比毫无意义。故按「本次最高分 × 阈值」做相对截断。</p>

 *

 * <p>⚠️ 它治的是「噪音太多」,<b>治不了「排序错」</b>:若排第一的本身就是字面命中

 * 但语义无关的切片(ngram 双字分词的常见噪音),阈值只会连同它一起把后面的砍掉,

 * 头名仍然是它。排序问题要靠向量路的语义召回,不能指望这个旋钮。</p>

 */

private Map<Long, Double> keywordCandidates(KbRetrievalQuery query) {

    try {

        List<KbChunkScore> rows = kbChunkMapper.searchIdsByKeyword(

                query.getQuestion(), query.getBaseIds(), Math.max(1, properties.getKeywordTopK()));

        if (rows.isEmpty()) {

            return Map.of();

        }

        // 相对阈值:以本路最高 BM25 得分为基准;阈值 <= 0 时不启用

        double ratio = query.getMinSimilarity() != null

                ? query.getMinSimilarity()

                : properties.getMinSimilarity();

        double maxScore = rows.stream()

                .mapToDouble(row -> row.getScore() == null ? 0D : row.getScore())

                .max()

                .orElse(0D);

        boolean filtering = ratio > 0 && maxScore > 0;

        Map<Long, Double> hits = new LinkedHashMap<>();

        for (KbChunkScore row : rows) {

            if (row.getChunkId() == null) {

                continue;

            }

            double score = row.getScore() == null ? 0D : row.getScore();

            if (filtering && score < maxScore * ratio) {

                continue;

            }

            hits.putIfAbsent(row.getChunkId(), score);

        }

        return hits;

    } catch (Exception e) {

        log.warn("关键词召回失败,本次降级为纯向量召回:{}", e.getMessage());

        return Map.of();

    }

}这一段的认知很重要:BM25 得分没有固定量纲,实测同一个库里的分数既可能是 0.5 也可能是 10+,随语料与分词漂移。所以不能拿一个”绝对阈值”去比——只能按「本次最高分 × 阈值」做相对截断。
而且注释里明确写了这个旋钮治不了排序错:如果排第一的就是字面命中但语义无关的切片,阈值只会连同它一起把后面的砍掉,头名仍然是它。排序问题只能靠向量路的语义召回。
4.2 为什么必须保留关键词召回
这是全篇最值得强调的一点。
纯向量检索对「型号 KB-2200」「错误码 E1042」这类低频精确串召回很差——因为这类 token 在训练语料里几乎不出现,模型没学过它们的语义,向量表示也就没有区分度。
而企业知识库里这类查询占比很高:设备型号、零件编号、错误码、工单号,恰恰是员工最常查的东西。
所以两路都做:向量负责语义(”怎么退款”匹配”退货流程”),关键词负责精确匹配(”E1042″必须命中包含这个串的文档)。成本几乎为零,收益却很大。
五、RRF 融合
两路结果怎么合并?用 RRF(Reciprocal Rank Fusion,倒数排名融合):
/**

 * RRF 融合:按排名倒数加权,而不是按分数加权。

 *

 * <p>好处是不需要调权重。向量相似度(0~1 的余弦值)和 BM25 分数(无上界的实数)

 * 本来就不在同一个量纲上,硬要加权就得先归一化,而归一化参数又要靠调。

 * RRF 只看排名,天然绕开这个问题。</p>

 *

 * <p>k 是平滑常数,论文取值 60:k 越大,头部排名的优势越平缓。</p>

 */

private Map<Long, Double> fuse(Map<Long, Double> vectorHits, Map<Long, Double> keywordHits) {

    double k = Math.max(1, properties.getRrfK());

    Map<Long, Double> fused = new HashMap<>();


    // 向量路:按相似度倒序,逐条累加 1/(k + rank)

    accumulate(fused, vectorHits, k);

    // 关键词路:按 BM25 倒序,同样累加

    accumulate(fused, keywordHits, k);


    return fused;

}


private void accumulate(Map<Long, Double> fused, Map<Long, Double> hits, double k) {

    List<Long> ranked = hits.entrySet().stream()

            .sorted(Map.Entry.<Long, Double>comparingByValue().reversed())

            .map(Map.Entry::getKey)

            .toList();

    for (int i = 0; i < ranked.size(); i++) {

        double rank = i + 1;   // 排名从 1 开始

        fused.merge(ranked.get(i), 1.0 / (k + rank), Double::sum);

    }

}
为什么 RRF 优于加权求和?因为两路的分数根本不在同一量纲上——向量相似度是 0~1 的余弦值,BM25 是无上界的实数。硬要加权就得先归一化,而归一化参数又要靠调。RRF 只看排名,天然绕开这个问题,而且更稳定:某一路的分数突然异常也不会主导结果。
k=60 不要随手调。k 越大,头部排名的优势越平缓;改它会明显改变融合结果。
六、租户过滤:第一道闸
/**

 * 构造向量过滤表达式。

 *

 * <p><b>这是租户隔离的第一道闸</b>:向量库不归 MyBatis 租户拦截器管,

 * 没有这个 filter,检索会跨租户返回结果。Qdrant 的 payload 过滤不需要预先声明字段

 * (官方实现把 filter expression 翻成 Qdrant 的 Filter;建 payload index 只为性能)

 * —— 所以这里要防的不是「条件被忽略」,而是 filter 本身写漏:

 * 那种情况同样不报错,只是把别的租户的内容一起召回。</p>

 *

 * <p>值必须带单引号:这些字段是 tag(字符串)类型,写成数字会匹配不上。

 * 租户为 null(平台超管)时不加该条件,与拦截器「无租户上下文则不过滤」口径一致。</p>

 */

private String buildFilterExpression(KbRetrievalQuery query) {

    List<String> conditions = new ArrayList<>(2);

    Long tenantId = UserUtils.getTenantId();

    if (tenantId != null) {

        conditions.add(KbConstants.META_TENANT_ID + " == '" + tenantId + "'");

    }

    if (query.getBaseIds() != null && !query.getBaseIds().isEmpty()) {

        String joined = query.getBaseIds().stream()

                .map(id -> "'" + id + "'")

                .collect(Collectors.joining(","));

        conditions.add(KbConstants.META_BASE_ID + " in [" + joined + "]");

    }

    return conditions.isEmpty() ? null : String.join(" && ", conditions);

}
三个细节:
① 值必须带单引号。这些 metadata 字段在 Qdrant 里是 tag(字符串)类型,写成数字会匹配不上——而且不报错,只是召不回任何结果。
② 租户为 null 时不加条件,与拦截器”无租户上下文则不过滤”的口径一致(平台超管场景)。
③ 这是第一道闸,不是唯一一道。结果回来后还要按 MySQL 二次校验 tenant_id——因为 filter 写漏不会报错,只会静默跨租户。两道闸都不能省。
七、重排(可选)
// 重排永不抛出:失败时返回原顺序(见 KbRerankService 契约)

hits = kbRerankService.rerank(query.getQuestion(), hits);重排用对话模型对候选一次性批量打分后重新排序,默认关闭。
两个约束:
① rerank.candidates 必须 ≥ final-top-k,否则”重排”就退化成了”给最终那几条重新排个序”,没有实际意义。
② Agent 多跳时显式关闭重排——多跳本身就会调很多次模型,每跳再叠一次重排,模型调用次数会成倍放大。
八、小结
这一篇的要点:
- 双路召回不是可选项——纯向量在型号、错误码这类精确串上表现很差,而企业知识库里这类查询占比很高
- RRF 优于加权融合——不同来源的分数不在同一量纲,按排名融合既免调参又更稳定
- BM25 的阈值是相对强度——它没有固定量纲,只能按”最高分 × 比例”截断
- 向量检索的租户过滤要显式传——MyBatis 拦截器管不到它,写漏了不报错、只泄漏
还有一个容易忽略的点:切片的租户归属必须从文档继承。补偿任务跑在无上下文的调度线程里,靠基类自动填充会留下空租户,导致文档”解析成功但检索不到”。
下一篇讲引用溯源与流式输出。