工具篇解决的是「模型能对外做点什么」,这一篇换个方向:模型返回的东西,怎么让程序稳定地接住。自然语言回答给人读很舒服,给代码读就不行——一句话换个说法、多一个「约」字,你的解析就崩了。结构化输出(Structured Output)就是把这个不确定性压下去。
20.1 结构化输出要的不是文本,是数据对象
LangChain 里的结构化输出,指要求模型最终返回一个符合预定义结构的数据:固定字段的 JSON、Pydantic 模型或 TypedDict,而不是无格式的自然语言。核心目标一句话:把「自然语言回答」变成「程序可以稳定消费的数据」。
比如问一部电影的信息,模型平时会这样回:
盗梦空间在 2010 年上映,导演是克里斯托弗·诺兰,评分 9.3。
结构化输出要的是这个:
{
    "title": "盗梦空间",
    "year": 2010,
    "director": "克里斯托弗·诺兰",
    "rating": 9.3
}
差别看着只是格式,实际是三种收益:代码可以直接读字段,不用再写正则从自然语言里抠;结果更稳定,不会因为模型换个说法就解析失败;更适合工程化,表单抽取、分类、路由、工具参数生成、工作流状态传递,全都依赖固定结构。
20.2 不用结构化输出会怎样
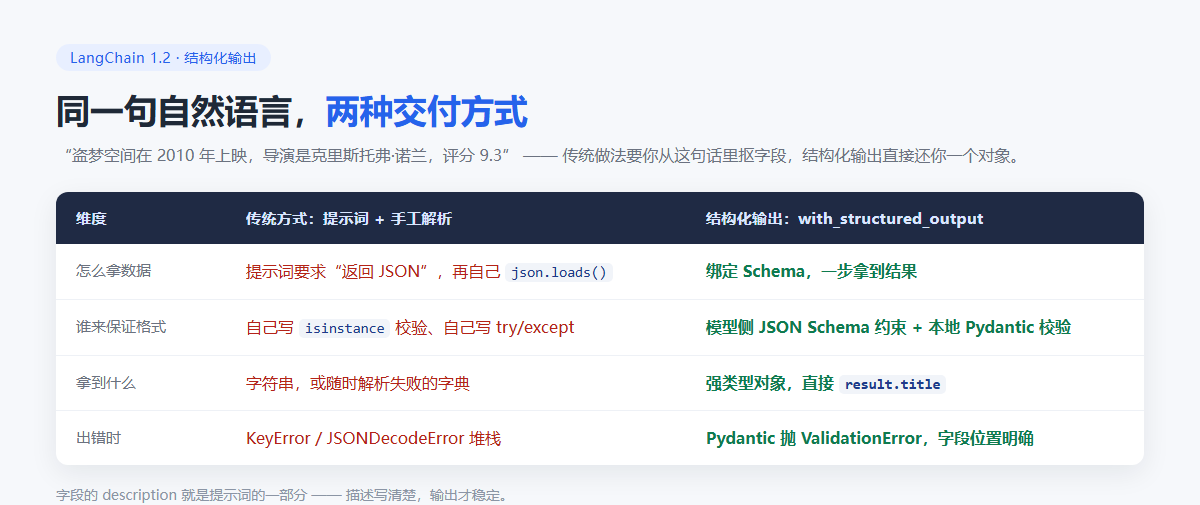
老办法是这样的:提示词里求模型返回 JSON,然后自己解析、自己校验。
# 1. 提示词要求 JSON
prompt = "以 JSON 格式返回:{name, age, occupation}"
response = model.invoke(prompt)

# 2. 手动解析
import json
data = json.loads(response.content)

# 3. 手动验证类型
if not isinstance(data["age"], int):
    raise ValueError("age must be int")

# 4. 手动创建对象
person = Person(**data)
这段代码能跑,但每一步都在赌:赌模型不加「好的,以下是 JSON:」,赌字段名没写错,赌类型是对的。换了模型、升级了版本,任何一环变动都要重新调提示词。
换成 with_structured_output(),四步并成一步:
# 一步到位
structured_llm = model.with_structured_output(Person)
person = structured_llm.invoke("张三是一名 30 岁的软件工程师")
# 自动解析、验证、创建对象为什么这套机制受欢迎,原因有三条:提示词变干净,字段的 description 直接充当提示词的一部分,不用再苦口婆心地说「请只返回 JSON」;类型安全,编辑器能补全,运行前就能查错;稳定性来自模型底层,依托厂商的 JSON 模式或函数调用,输出错误率极低。
两者的实测差别可以看这张对照:
20.3 四种 Schema,两个共性
LangChain 1.x 支持四种 Schema:
| Schema | 特点 | 返回值 |
|---|---|---|
| Pydantic | 字段校验、描述、嵌套结构,功能最丰富,生产首选 | Schema 类实例 |
| TypedDict | 轻量类型约束,写起来接近普通 dict | 字典 |
| JSON Schema | 与前后端、跨语言接口最通用,但要手写 JSON | 字典 |
| @dataclass | 标准库写法,最省依赖 | 字典 |
记住两个共性,后面会反复用到:
- 只有 Pydantic 返回 Schema 类实例,另外三种都返回
dict; - 只有 Pydantic 会在类型不匹配时抛异常,其余三种拿到什么就是什么。
还有一个现实问题:所有模型都支持吗?大多数现代模型支持(OpenAI 的 gpt-4 系列、Anthropic 的 claude-3、Groq 上的 llama-3),因为它们底层走的是函数调用;少数旧模型不支持,这时 LangChain 会自动回退到「提示词 + JSON 解析」,能用但不保证稳。
20.4 取结果的两种方式
20.4.1 with_structured_output:推荐
先定义结构,再绑到模型上,调用方式和普通 invoke 一样:
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field
import os
from dotenv import load_dotenv

load_dotenv(override=True)
model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)

class Movie(BaseModel):
    """电影信息"""
    title: str = Field(description="电影标题")
    year: int = Field(description="上映年份")
    director: str = Field(description="导演")
    rating: float = Field(description="评分(10 分制)")

model_with_structure = model.with_structured_output(Movie)
result = model_with_structure.invoke("给我介绍下电影《星际穿越》")

print(type(result))          # <class '__main__.Movie'>
print(result.title)          # 星际穿越
print(result.rating)         # 9.3
返回的是 Movie 实例,属性直接点。这一点决定了它和另外三种模式的用法差异:不用 result["title"],而是 result.title。
20.4.2 include_raw=True:还要原始响应
有时候你需要 token 用量、finish_reason 这些元数据,或者想自己处理解析失败。给 with_structured_output 加上 include_raw=True,返回的就不再是对象,而是三件套:
model_with_structure = model.with_structured_output(Movie, include_raw=True)
resp = model_with_structure.invoke("给我介绍下电影《星际穿越》")

print(type(resp))     # <class 'dict'>
print(resp.keys())    # dict_keys(['raw', 'parsed', 'parsing_error'])
{
'raw': AIMessage(content='', ... response_metadata={'token_usage': {
'completion_tokens': 93, 'prompt_tokens': 373, 'total_tokens': 466, ...},
'finish_reason': 'tool_calls', ...},
tool_calls=[{'name': 'Movie', 'args': {'title': '星际穿越', 'year': 2014,
'director': '克里斯托弗·诺兰', 'rating': 9.3}, ...}]),
'parsed': Movie(title='星际穿越', year=2014, director='克里斯托弗·诺兰', rating=9.3),
'parsing_error': None
}三个字段各管一段:raw 是原始 AIMessage(想看用量、想知道模型走了 tool_calls 还是 JSON 模式,就看这里);parsed 是解析后的对象;parsing_error 是解析错误——注意它只对 Pydantic 有意义,另外三种 schema 不符合时压根不会报错,这个字段永远是 None。
20.4.3 输出解析器:老办法,不推荐
在 with_structured_output 之前,标准做法是「提示词要求格式 → 模型生成文本 → 解析器转换」,用 JsonOutputParser 串一条链:
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import ChatPromptTemplate

prompt_template = ChatPromptTemplate.from_messages([
    ("system", "回答用户问题,必须始终输出一个包含 title(电影标题)和 year(上映年份)的 JSON 对象"),
    ("human", "问题:{question}"),
])

class Movie(BaseModel):
    """电影信息"""
    title: str = Field(description="电影标题")
    year: int = Field(description="上映年份")

parser = JsonOutputParser(pydantic_object=Movie)
chain = prompt_template | model | parser

response = chain.invoke({"question": "介绍电影《盗梦空间》"})
print(response)   # {'title': '盗梦空间', 'year': 2010}
它有三个明显短板:靠提示词约束格式,模型加一句解释就解析失败;解析器只做 JSON 解析,字段缺失、类型错误要自己补;多一层链,调试时更难定位问题在哪。新项目没有理由再用它,唯一例外是老代码里已经这么写了。
20.5 小结
这一篇建立概念:结构化输出是把自然语言回答转成程序能消费的数据;四种 Schema 里只有 Pydantic 返回实例并做校验;取结果首选 with_structured_output(),需要原始响应就加 include_raw=True;输出解析器属于历史方案。
下一篇把 Pydantic 这一种讲透:description 为什么等于提示词,可选字段、默认值、枚举、列表、嵌套各自怎么写,以及 with_structured_output 在底层到底做了哪四步。
上一篇:工具实战——多工具循环、tool_choice 与踩坑清单;系列第一篇:为什么需要 LangChain。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。