四种 Schema 里,Pydantic 是唯一既返回对象又做校验的一种,也因此是生产场景的默认选择。这一篇把它讲透:字段怎么定义、描述怎么写、可选值和默认值有什么区别、枚举和嵌套怎么组织,最后看它底层到底跑了几步。
21.1 一个能用的模型只要三样东西
Pydantic 通过在运行时强制执行类型提示来保证数据正确。写一个结构化输出模型,需要三个要素:
- 继承
BaseModel,所有结构化输出的数据模型都必须继承它; - 用类型提示声明字段,
str、int、float、List[xxx]、Optional[xxx]都支持; - 用
Field()补默认值和描述,描述会变成给模型看的说明。
from pydantic import BaseModel, Field

class Person(BaseModel):
    """人物信息"""
    name: str = Field(description="姓名")
    age: int = Field(description="年龄")
    occupation: str = Field(description="职业")

structured_llm = model.with_structured_output(Person)
result = structured_llm.invoke("张三是一名 30 岁的软件工程师")

print(result)                 # name='张三' age=30 occupation='软件工程师'
print(type(result))           # <class '__main__.Person'>
print(result.name)            # 张三
print(result.age)             # 30
print(result.occupation)      # 软件工程师
关键在于 BaseModel 不是「随便一个类」:LangChain 会读出它的 JSON Schema,要求模型按这个结构输出,拿到响应后再用 Pydantic 做一次真实校验,通过才返回实例。
21.2 描述不是注释,是提示词
Field(description=...) 里的内容会被塞进发给模型的 Schema。
class MovieModel(BaseModel):
    """电影的详细信息"""
    title: str = Field(description="电影标题")
    year: int = Field(description="电影上映年份")
    director: str = Field(description="导演")
    rating: float = Field(description="电影评分,满分十分")

model_with_structure = model.with_structured_output(MovieModel)
response = model_with_structure.invoke("给出盗梦空间的信息")
print(response)
# title='盗梦空间' year=2010 director='克里斯托弗·诺兰' rating=9.3
把 rating 的描述写成「评分」,模型可能给 93;写成「满分十分」,它就知道该给 9.3。没有描述,模型只能靠猜字段含义,格式错误率明显上升——这也是为什么上一种 Schema 方式(纯类型注解、不写描述)在生产里不推荐。
21.3 LLM 没填的字段:Optional
问「张三是一名医生」,模型不知道年龄,会怎么处理?
class Person(BaseModel):
    """人物信息"""
    name: str = Field(description="姓名")
    age: int = Field(description="年龄")      # 必填
    occupation: str = Field(description="职业")

structured_llm = model.with_structured_output(Person)
structured_llm.invoke("张三是一名医生")
# Person(name='张三', age=0, occupation='医生')
必填的 int 被补成了 0。这个 0 是有害的:下游会当成真实年龄。改成可选字段:
from typing import Optional

class Person(BaseModel):
    """人物信息"""
    name: str = Field(description="姓名")
    age: Optional[int] = Field(description="年龄")     # 可选
    occupation: str = Field(description="职业")

structured_llm.invoke("张三是一名医生")
# Person(name='张三', age=None, occupation='医生')
None 至少能表达「没有这个信息」,比伪造的 0 安全。实践建议:凡是用户可能没说、文档里可能没有的字段,一律 Optional。
21.4 默认值:一个不太可靠的兜底
另一种写法是给默认值:
class Person(BaseModel):
    """人物信息"""
    name: str = Field(description="姓名")
    age: int = Field(1, description="年龄")
    occupation: str = Field(description="职业")

structured_llm.invoke("张三是一名医生")
# CloseAI 平台的 gpt 模型:Person(name='张三', age=0, occupation='医生')
# OpenRouter 平台的 gpt 模型:Person(name='张三', age=1, occupation='医生')
同一段代码,两个平台给出不同结果:CloseAI 的模型仍然填 0,OpenRouter 的模型用了默认值 1。不同模型提供商对 default 的支持不一致,所以默认值不能当校验手段用。
多字段更能看出差别:
class Config(BaseModel):
    timeout: Optional[int] = Field(30, description="超时时间(单位秒)")
    retry: bool = Field(False, description="是否支持重试")
    max_attempts: int = Field(6, description="最大重试次数")

structured_llm = model.with_structured_output(Config)
structured_llm.invoke("配置要求:支持重试,最多重试 5 次")
# Config(timeout=None, retry=True, max_attempts=5)
timeout 有默认值 30,但因为是 Optional,模型选了 None;max_attempts 用户明确说了 5,就取 5。结论:需要「没提供就用固定值」时用默认值,需要「没提供就表示没有」时用 Optional,两者别混。
21.5 枚举与字面量:把可选值锁死
str 类型的字段,模型可能返回「高」「紧急」「高优先级」三种说法。要限制取值,用枚举:
from enum import Enum

class Priority(str, Enum):
    LOW = "低"
    MEDIUM = "中"
    HIGH = "高"

class Task(BaseModel):
    title: str
    priority: Priority      # 只能是 LOW / MEDIUM / HIGH
class Status(str, Enum):
ACTIVE = "激活"
INACTIVE = "未激活"
class User(BaseModel):
status: Status # 只能是 ACTIVE 或 INACTIVE完整一点的例子是客服工单抽取:
class CustomerInfo(BaseModel):
    """客户信息"""
    name: str = Field(description="客户姓名")
    phone: str = Field(description="电话号码")
    email: Optional[str] = Field(description="邮箱")
    issue: str = Field(description="问题描述")
    urgency: Priority = Field(description="紧急程度")

structured_llm = model.with_structured_output(CustomerInfo)
conversation = """
客服:您好,请问有什么可以帮助您?
客户:我是王小明,电话 138-1234-5678,我的订单一直没发货,很着急!
客服:好的,我帮您查一下
"""
result = structured_llm.invoke(f"从以下客服对话中提取客户信息:\n{conversation}")

print(result)
# name='王小明' phone='138-1234-5678' email=None issue='订单一直没发货,很着急'
# urgency=<Priority.HIGH: '高'>
print(result.urgency.value)   # 高
注意 result.urgency 是枚举成员,取中文要 .value。这套写法在自动填充 CRM、工单分类、客服辅助里很常见,因为下游系统通常只接受固定的几档值。
嫌单独定义 Enum 类麻烦,可以直接用 Literal 把允许值写在字段上:
from typing import Literal

class CustomerInfo(BaseModel):
    """客户信息"""
    name: str = Field(description="客户姓名")
    phone: str = Field(description="电话号码")
    email: Optional[str] = Field("未提供", description="邮箱")
    issue: str = Field(description="问题描述")
    urgency: Literal["低", "中", "高"] = Field(description="紧急程度")
此时 result.urgency 就是字符串 '高',不用再 .value。少量固定值时用 Literal 更省事,多个模型共用一套取值时用 Enum 更好维护。
21.6 列表与嵌套结构
一次抽取多条记录,用 List 包一层:
from typing import List

class Person(BaseModel):
    """人物信息"""
    name: str
    age: int

class PersonList(BaseModel):
    """人物列表信息"""
    people: List[Person]

structured_llm = model.with_structured_output(PersonList)
result = structured_llm.invoke("张三 30 岁,李四 25 岁")
print(result)
# people=[Person(name='张三', age=30), Person(name='李四', age=25)]
嵌套模型就是字段类型换成另一个 BaseModel:
class Address(BaseModel):
    """地点描述"""
    city: str
    district: str

class Company(BaseModel):
    """公司信息"""
    name: str
    address: Address       # 嵌套模型

structured_llm = model.with_structured_output(Company)
print(structured_llm.invoke("阿里巴巴在杭州滨江区"))
# name='阿里巴巴' address=Address(city='杭州', district='滨江区')
列表 + 嵌套组合起来,才是抽取类任务的主力写法:
class Actor(BaseModel):
    """演员信息"""
    name: str = Field(description="演员姓名")
    role: str = Field(description="饰演的角色")

class Movie(BaseModel):
    """电影信息"""
    title: str = Field(description="电影标题")
    year: int = Field(description="上映年份")
    director: str = Field(description="导演")
    cast: List[Actor] = Field(description="演员列表")
    rating: float = Field(description="评分")

structured_model = model.with_structured_output(Movie)
response = structured_model.invoke("请介绍电影《盗梦空间》")
print(response.cast[0].name)     # 莱昂纳多·迪卡普里奥
print(response.cast[0].role) # 柯布这里有个现实约束:嵌套层级建议不超过 3 层,复杂嵌套模型容易出错,必要时拆成多次调用。四层嵌套(User → Company → Address → Country)在演示里就经常见到字段丢失。
21.7 限制条件:让 Pydantic 帮你拦
Field 除了描述和默认值,还能加约束:长度、范围。
from pydantic import ValidationError

class User(BaseModel):
    name: str = Field(min_length=2, max_length=20)
    age: int = Field(ge=0, le=150)
    email: str

try:
    User(name="李四", age=200, email="li@example.com")
except ValidationError as e:
    print(f"[FAIL] 验证失败(符合预期): {e.errors()[0]['msg']}")
# [FAIL] 验证失败(符合预期): Input should be less than or equal to 150
同样的约束放到工具/抽取场景里,能挡住模型的幻觉数值:
class Product(BaseModel):
    """产品信息(严格验证)"""
    name: str = Field(description="产品名称(字符串类型)", min_length=2)
    price: float = Field(description="价格,数字类型", gt=0)
    stock: int = Field(description="库存,整数类型", ge=0)

structured_llm = model.with_structured_output(Product)
# 输入里的价格和库存都是负数
response = structured_llm.invoke("华为 mate 80 promax 价格是 -7999,当前库存 -100")
print(response)
# name='华为 mate 80 promax' price=1.0 stock=0
不同平台的处理不一样:CloseAI 上的模型直接改正成 price=7999.0 stock=100,OpenRouter 上的模型退到最小的合法值 price=1.0 stock=0。形式不同,但都说明一件事——约束生效了,非法值没被原样传出来。这就是 Pydantic 相对另外三种模式最大的价值。
21.8 底层:四步,谁都不白干
把 with_structured_output(Person) 拆开看,LangChain 做了四件事:
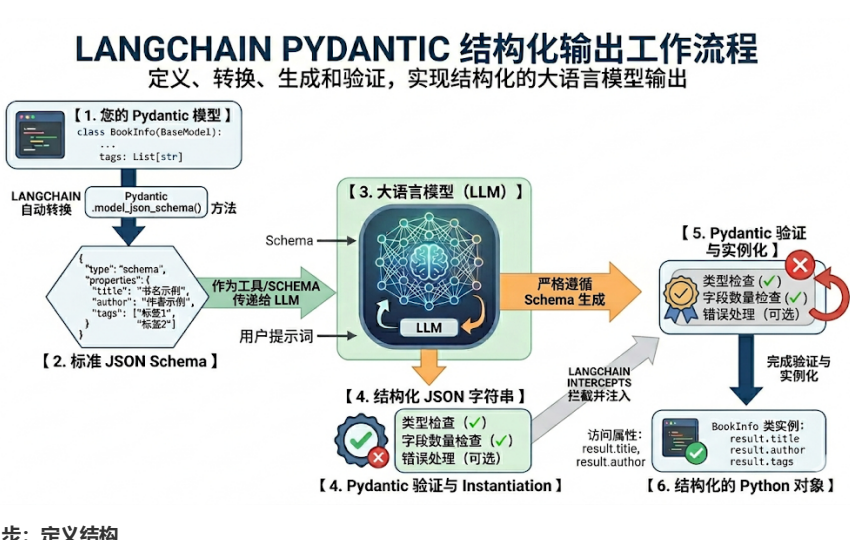
第 1 步:定义结构。你写 BaseModel 子类,声明字段、类型、描述。
from pydantic import BaseModel, Field

class BookInfo(BaseModel):
    title: str = Field(description="书名")
    author: str = Field(description="作者名字")
    tags: list[str] = Field(description="书籍的标签或分类")
第 2 步:协议转换。LangChain 调用 Pydantic 的底层方法(如 model_json_schema()),把你的 Python 类自动转成标准 JSON Schema——一段严格的 JSON 文本,写明有哪些字段、字段类型(string、array 等)、以及每个字段的描述。
第 3 步:模型交互与强约束。这份 JSON Schema 被包装进 API 请求。现代模型普遍支持函数调用或 JSON Mode,LangChain 会把 Schema 当作 Tools 传进去;像 OpenAI 的 strict=True 还会启动语法采样约束(Grammar-based sampling),模型生成 token 时按 Schema 的语法树选择,从解码层面保证格式不走样。
第 4 步:自动解析与验证。模型返回符合规范的字符串后,PydanticStructuredOutputParser 接管:先解析成 Python 字典,再把字典喂给 Pydantic 模型校验。字段缺失或类型错误在这里抛错(或触发 LangChain 的重试),通过则返回可直接点属性的对象。
理解了这四步,前面几个现象就都能解释:为什么 description 有用(它在第 2 步进了 Schema)、为什么 Optional 和默认值行为不一致(第 3 步由模型决定填不填)、为什么只有 Pydantic 会报错(第 4 步只有它做了校验)。
21.9 小结
Pydantic 模式的写法有固定套路:继承 BaseModel、字段带类型提示、用 Field 写描述;可选值用 Optional,固定取值用 Enum 或 Literal,多条记录用 List,从属关系用嵌套模型(不超过 3 层),范围限制用 ge/le/gt/min_length。
下一篇看另外三种:TypedDict 的 Annotated 怎么写、JSON Schema 的 method 参数有什么坑、@dataclass 为什么返回的是未校验字典,以及用 fake server 做的那组校验对比实验。
上一篇:结构化输出——让模型返回程序能吃的对象;系列第一篇:为什么需要 LangChain。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。