定义方式讲完,接下来是把它跑起来。这一篇的四个案例从最简单的单工具一直走到多工具循环,然后解决一个实际问题:怎么让模型「必须调工具」或者「只能调某一个工具」。最后是几条踩过坑的经验。
19.1 案例 1:用 args_schema 跑通完整链路
先给参数加上明确的结构。下面的 WeatherSchema 两个字段都带默认值和描述,模型不填也能跑:
from pydantic import BaseModel, Field
from langchain.tools import tool
from langchain.messages import HumanMessage
from langchain_core.utils.function_calling import convert_to_openai_tool

class WeatherSchema(BaseModel):
    city: str = Field(default="北京", description="城市名称")
    if_forecast: bool = Field(default=False, description="是否包含明日天气预报")

@tool("get_weather_and_forecast",
      description="查询当日天气,可以包含明日天气预报",
      args_schema=WeatherSchema)
def get_weather(city: str, if_forecast: bool):
    res = f"{city}今天天气不错"
    if if_forecast:
        res += "\n明天也不错"
    return res

print(convert_to_openai_tool(get_weather))
{'type': 'function', 'function': {
'name': 'get_weather_and_forecast',
'description': '查询当日天气,可以包含明日天气预报',
'parameters': {'properties': {
'city': {'default': '北京', 'description': '城市名称', 'type': 'string'},
'if_forecast': {'default': False, 'description': '是否包含明日天气预报', 'type': 'boolean'}},
'type': 'object'}}}挂到模型上跑完整四步:
model_with_tools = model.bind_tools([get_weather])
messages = [HumanMessage("今天杭州天气如何?明天呢?")]

response = model_with_tools.invoke(messages)
messages.append(response)

for tool_call in response.tool_calls:
    if tool_call["name"] == "get_weather_and_forecast":
        tool_msg = get_weather.invoke(tool_call)   # 返回 ToolMessage
        messages.append(tool_msg)

final_response = model_with_tools.invoke(messages)
messages.append(final_response)

for msg in messages:
    msg.pretty_print()
输出里最关键的是模型自己把 if_forecast 填成了 True——因为用户问「明天呢」。参数描述写清楚了,模型就能把自然语言里的隐含意图落到结构化参数上。
================================ Human Message ================================
今天杭州天气如何?明天呢?
================================== Ai Message ==================================
Tool Calls:
  get_weather_and_forecast (call_c82UrCpAdVAqiHfl4OkZocbg)
  Args:
    city: 杭州
    if_forecast: True
================================= Tool Message ==================================
Name: get_weather_and_forecast
杭州今天天气不错
明天也不错
================================== Ai Message ==================================
杭州今天:天气不错。
杭州明天:也不错。
19.2 案例 2:把描述写在 docstring 里
不想用 args_schema,也可以把参数说明写进 docstring,此时参数的类型和默认值仍然由函数签名提供,两边分工明确:
@tool("get_weather_and_forecast", parse_docstring=True)
def get_weather(city: str = "北京", if_forecast: bool = False):
    """
    查询当日天气,可以包含明日天气预报
    Args:
        city: 城市名称
        if_forecast: 是否包含明日天气预报
    """
    res = f"{city}今天天气不错"
    if if_forecast:
        res += "\n明天要下雨"
    return res

print(convert_to_openai_tool(get_weather))
{'type': 'function', 'function': {
'name': 'get_weather_and_forecast',
'description': '查询当日天气,可以包含明日天气预报',
'parameters': {'properties': {
'city': {'default': '北京', 'description': '城市名称', 'type': 'string'},
'if_forecast': {'default': False, 'description': '是否包含明日天气预报', 'type': 'boolean'}},
'type': 'object'}}}生成的 Schema 与案例 1 一模一样,区别只在维护成本:描述散在 docstring 里,改起来快;结构复杂时更容易写错。parse_docstring=True 这个开关不能漏,漏了 Args: 就只是一段没人解析的文本。
19.3 案例 3:一次响应里多个工具调用
模型一次推理可以同时请求多个工具。下面问「天气 + 新闻」,模型在同一个 AIMessage 里给出两个 tool_call:
from langchain.tools import tool
from langchain.messages import HumanMessage

@tool(parse_docstring=True)
def get_weather(city: str) -> str:
    """
    获取当日天气
    Args:
        city: 城市名称
    """
    return f"{city}当天晴朗"

@tool(parse_docstring=True)
def get_news() -> str:
    """
    获取当日新闻
    """
    return "多地回收商称废旧手机回收市场迎来涨价潮。"

model_with_tools = model.bind_tools([get_weather, get_news])
messages = [HumanMessage("今天杭州天气如何?今天新闻是什么?别瞎编")]

response = model_with_tools.invoke(messages)
messages.append(response)
response.pretty_print()
================================== Ai Message ==================================
我来帮您查询杭州的天气和今日新闻。
Tool Calls:
get_weather (call_00_uspkbqR7N7wIewhr8hHZAXoM)
Args:
city: 杭州
get_news (call_01_ksyZoO2kXFBXXp1dH4dnxZAN)
Args:处理方式就是遍历 tool_calls,挨个调用:
for tool_call in response.tool_calls:
    if tool_call["name"] == "get_weather":
        messages.append(get_weather.invoke(tool_call))
    elif tool_call["name"] == "get_news":
        messages.append(get_news.invoke(tool_call))
    else:
        raise Exception("不存在的工具")

final_response = model.invoke(messages)
messages.append(final_response)
注意最后一步用的是 model.invoke() 而不是 model_with_tools.invoke()——工具结果已经齐了,这一轮只需要模型把结果写成自然语言,没必要再给它调工具的机会。两种写法结果通常一样,但前者更不容易出现「模型又想调一次」的情况。那个 else 分支也别省:模型偶尔会编出一个不存在的工具名,不拦就会静默丢结果。
19.4 案例 4:多个工具 + 多轮循环
真实任务往往要「先查股价,再查新闻,最后总结」。模型一次推理只给一个结果,多步就要自己写循环:
from langchain_core.tools import tool
from langchain_core.messages import HumanMessage

@tool(parse_docstring=True)
def get_stock_price(company: str, timeframe: str = "today") -> str:
    """获取指定公司的股票价格信息
    Args:
        company: 公司名称(如:苹果公司、微软公司、谷歌公司)
        timeframe: 时间范围(today-今日, week-本周, month-本月)
    """
    mock_data = {
        "苹果公司": {"today": 185.20, "week": 183.50, "month": 180.75},
        "微软公司": {"today": 415.86, "week": 412.30, "month": 405.42},
        "谷歌公司": {"today": 15.42, "week": 15.20, "month": 14.85},
    }
    if company in mock_data:
        price = mock_data[company].get(timeframe, "未知时间范围")
        return f"{company} {timeframe} 价格: {price} 美元"
    return f"未找到股票代码 {company} 的数据"

@tool(parse_docstring=True)
def search_news(company: str) -> str:
    """搜索指定公司的财经新闻
    Args:
        company: 公司名称
    Returns:
        公司的财经新闻,每个新闻占一行
    """
    mock_news = {
        "苹果公司": ["苹果发布新款 iPhone,股价上涨 3%",
                     "苹果与欧盟达成反垄断和解协议",
                     "苹果将在印度扩大生产规模"],
        "微软公司": ["微软 Azure 云业务季度增长超预期",
                     "微软完成对 Nuance 的收购"],
        "谷歌公司": ["谷歌发布新 AI 模型,性能提升 20%"],
    }
    return "\n".join(mock_news.get(company, [f"未找到 {company} 的相关新闻"]))
循环骨架如下:每轮调用模型,模型不再请求工具就退出,否则执行工具并把结果塞回消息列表:
tools = [get_stock_price, search_news]
model_with_tools = model.bind_tools(tools)

message_list = [HumanMessage(content="苹果公司今天的股价是多少?最近有什么新闻?")]

while True:
    response = model_with_tools.invoke(message_list)
    message_list.append(response)

    if not response.tool_calls:
        print("没有工具调用,直接返回答案")
        break

    for tool_call in response.tool_calls:
        if tool_call["name"] == "get_stock_price":
            message_list.append(get_stock_price.invoke(tool_call))
        elif tool_call["name"] == "search_news":
            message_list.append(search_news.invoke(tool_call))
输出(第一轮模型同时要了两个工具,第二轮直接给答案):
================================ Human Message ================================
苹果公司今天的股价是多少?最近有什么新闻?
================================== Ai Message ==================================
Tool Calls:
  get_stock_price (call_cpGOhWce8rlIFSZ2G9w7ouON)
   Args: company: 苹果公司 / timeframe: today
  search_news (call_W9zjkAO8TNCmUbed2ld9tsxl)
   Args: company: 苹果公司
================================= Tool Message ==================================
Name: get_stock_price
苹果公司 today 价格: 185.2 美元
================================= Tool Message ==================================
Name: search_news
苹果发布新款 iPhone,股价上涨 3%
苹果与欧盟达成反垄断和解协议
苹果将在印度扩大生产规模
================================== Ai Message ==================================
苹果公司今天股价是 **185.2 美元**。最近新闻包括:
- 发布了新款 iPhone,带动股价上涨约 3%
- 与欧盟达成了反垄断和解协议
- 计划在印度扩大生产规模
没有工具调用,直接返回答案
把用户问题换成「海水为什么是咸的?」,第一轮就 break——模型判断不需要工具。这个 while True 加上 if not response.tool_calls: break,就是一个最朴素的 ReAct 循环;后面(二十一)以后讲 Agent 时,create_agent() 干的就是这件事。
19.5 用 tool_choice 控制调用行为
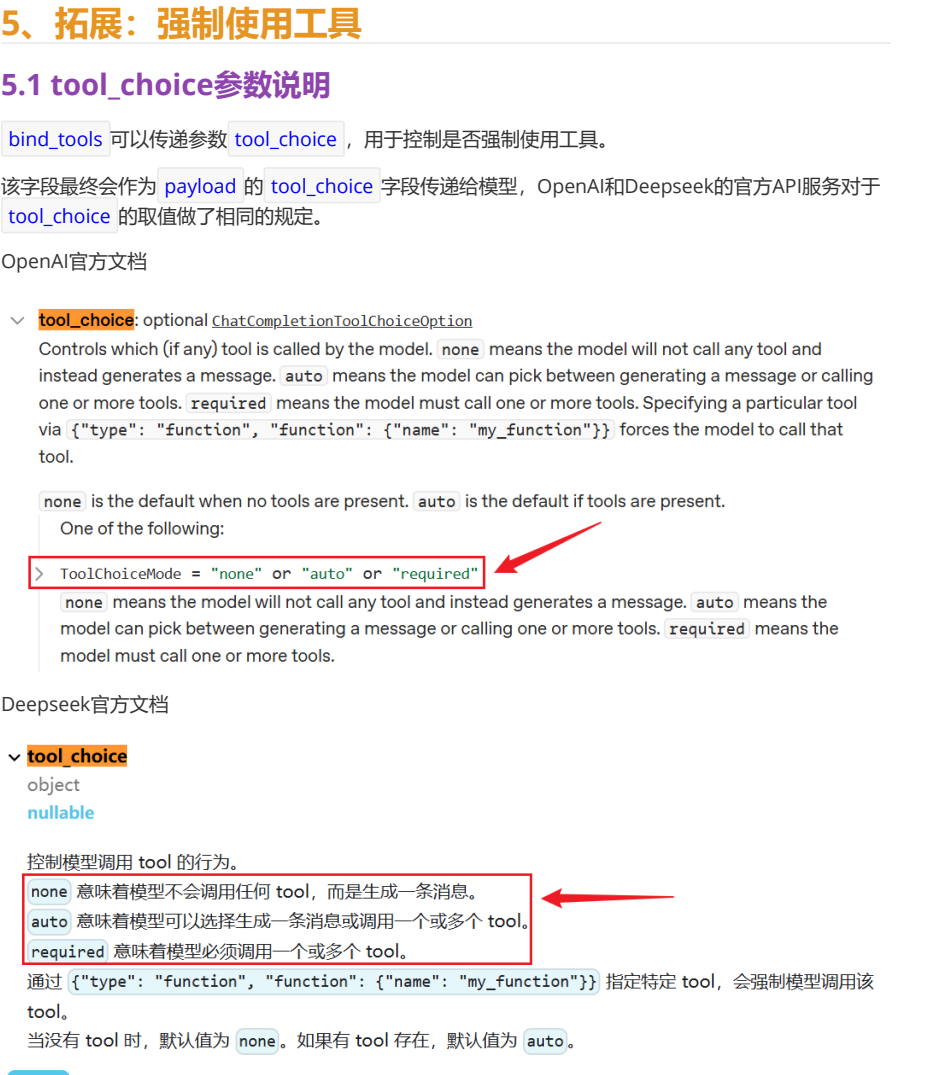
bind_tools() 的 tool_choice 参数最终作为请求里的 tool_choice 发给模型,OpenAI 与 DeepSeek 的取值规则一致:
| 取值 | 行为 | 典型场景 |
|---|---|---|
none |
不调用任何工具 | 同一套模型实例,只想聊天 |
auto |
默认值,模型自主决定调不调、调几个 | 日常对话 |
required |
必须调用工具,数量不限 | 表单抽取、结构化输出 |
any |
等价于 required |
同上 |
| 工具名字符串 | 强制调用指定工具 | 流程固定,不允许模型选别的 |
课件里截了 OpenAI 与 DeepSeek 两家的官方文档,取值口径一致:
none:用户明确要求实时天气,也给了天气工具,模型依然不会调用,而是老实说自己拿不到实时数据、建议去查天气应用。
model_with_tools = model.bind_tools([get_weather], tool_choice="none")
messages = [HumanMessage("今天北京天气如何?别瞎编")]
model_with_tools.invoke(messages).pretty_print()
================================== Ai Message ==================================
我无法直接获取实时天气数据。
如果您需要查询今天北京的准确天气情况,建议您:
1. 打开手机天气应用(如苹果天气、墨迹天气等)。
2. 在搜索引擎中搜索"北京天气"。
3. 查看中国气象局官网或权威天气平台。auto:模型自主判断。问天气就调工具,说「你好啊」就不调,直接聊。
model_with_tools = model.bind_tools([get_weather], tool_choice="auto")
# "今天杭州天气如何?别瞎编"  → Tool Calls: get_weather, Args: city: 杭州
# "你好啊" → 你好!很高兴见到你!有什么我可以帮助你的吗?required:不管需不需要都必须调,连「你好啊」都会变成一次 get_weather(city="北京")。这看起来很粗暴,但做信息抽取时正是想要的:用户说「帮我记一下明天下午三点开会」,你不希望模型自己决定「不回也罢」,而是强制它走工具落库。
model_with_tools = model.bind_tools([get_weather], tool_choice="required")
messages = [HumanMessage("你好啊")]
# 输出:Tool Calls: get_weather, Args: city: 北京
指定工具名:多个工具时锁定其中一个。下面的例子里两个工具描述完全一样,唯一的区别是 tool_choice 指谁,模型就调谁:
@tool(parse_docstring=True)
def get_weather1(city: str) -> str:
    """获取当日天气
    Args:
        city: 城市名称
    """
    return f"{city}当天晴朗"

@tool(parse_docstring=True)
def get_weather2(city: str) -> str:
    """获取当日天气
    Args:
        city: 城市名称
    """
    return f"{city}当天晴朗"

model_with_tools = model.bind_tools(
    [get_weather1, get_weather2], tool_choice="get_weather2"
)
messages = [HumanMessage("杭州今天天气如何?")]
# 输出:Tool Calls: get_weather2, Args: city: 杭州
把 tool_choice 改成 "get_weather1",调用就换成 get_weather1。工具名必须与注册时的一致——用 @tool("别名") 改过名的,这里要写别名。
19.6 实践经验:五个容易踩的点
1. 描述要清晰。模型只能看到 Schema 里的 description。写「做一些事情」的工具几乎不可能被正确调用;写清用途、参数格式、返回格式,命中率立刻不一样。写完用 convert_to_openai_tool() 打出来看一遍,这是最便宜的验证手段。
2. 一个工具只做一件事。把天气、计算、搜索塞进一个 do_everything(action, data),模型需要在参数里做二次决策,出错率成倍上升:
# ❌ 一个工具做太多事
@tool
def do_everything(action: str, data: str) -> str:
    """做各种事情"""
    if action == "weather": ...
    elif action == "calculate": ...
    elif action == "search": ...

# ✅ 每个工具做一件事
@tool
def get_weather(city: str) -> str:
    """获取天气"""
    ...

@tool
def calculator(operation: str, a: float, b: float) -> str:
    """计算"""
    ...
3. 工具失败要分层处理。第一层在工具内部兜住,把异常变成可读的错误信息返回给模型,让它有机会换个思路:
@tool
def divide(a: float, b: float) -> str:
    """
    除法计算
    Args:
        a: 被除数
        b: 除数
    """
    try:
        if b == 0:
            return "错误:除数不能为零"
        return f"{a} / {b} = {a / b}"
    except Exception as e:
        return f"计算错误:{e}"
第二层在 Agent 的提示词里给退路:create_agent(model=model, tools=[...], prompt="如果工具失败,尝试使用其他方法解决问题。")。第三层是整个调用级别的重试,用 tenacity 把网络抖动挡在外面:
from tenacity import retry, stop_after_attempt

# 失败最多尝试 3 次(1 次正常 + 2 次重试)
@retry(stop=stop_after_attempt(3))
def call_agent(question):
    return agent.invoke({"messages": [{"role": "user", "content": question}]})
流程很直白:正常返回时装饰器什么都不做;抛异常时拦下来重试;连续三次都失败才把错误抛出去。
4. 工具尽量返回字符串。大模型的输入本质是文本。返回 dict 时 LangChain 会强制转字符串,中文可能变成 {"name": "\u5f20\u4e09"} 这种 Unicode 转义。模型看得懂,但稳定性明显不如直接给中文:
import json

# ✅ 好:转成纯文本 JSON,中文不转义
@tool
def get_user_info(user_id: str) -> str:
    """获取用户信息"""
    user = {"id": user_id, "name": "张三"}
    return json.dumps(user, ensure_ascii=False)

# ❌ 不好:直接返回 dict
@tool
def get_user_info_v2(user_id: str) -> dict:
    """获取用户信息"""
    return {"id": user_id, "name": "张三"}
json.dumps(..., ensure_ascii=False) 是关键:默认 True 会把所有非 ASCII 字符转成 \uXXXX,关掉之后中文原样输出。
5. 按 IO 特性选同步还是异步。CPU 密集或纯计算的工具用同步;调用外部 API、读写数据库、操作文件的工具用异步,避免阻塞事件循环:
# 同步:本地计算
@tool
def sync_tool(x: str) -> str:
    return process(x)

# 异步:网络 IO
@tool
async def async_tool(x: str) -> str:
    return await async_process(x)
19.7 小结
四个案例的共同点是把「模型决策」和「代码执行」分得很清楚:模型负责生成调用请求,循环、参数校验、异常兜底都在你的代码里。tool_choice 则是在这层之上加的一道控制阀——需要确定性时用 required 或指定工具名,需要自由度时留着 auto。
工具是智能体的手脚。手脚齐了,下一步才是「谁来指挥这些手脚」——也就是 Agent。下一篇进入 LangChain 1.2 的智能体:create_agent() 怎么把上面这个 while True 循环封起来。
上一篇:工具的三种描述方式——docstring、@tool 与 args_schema;系列第一篇:为什么需要 LangChain。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。